
正在阅读:

曦智科技收入增长284%,为什么先卖起来的是光互连?

扫一扫下载界面新闻APP

曦智科技收入增长284%,为什么先卖起来的是光互连?

算力堵在路上。

文|Alpha说

曦智科技刚刚交出上市后的第一份中报。
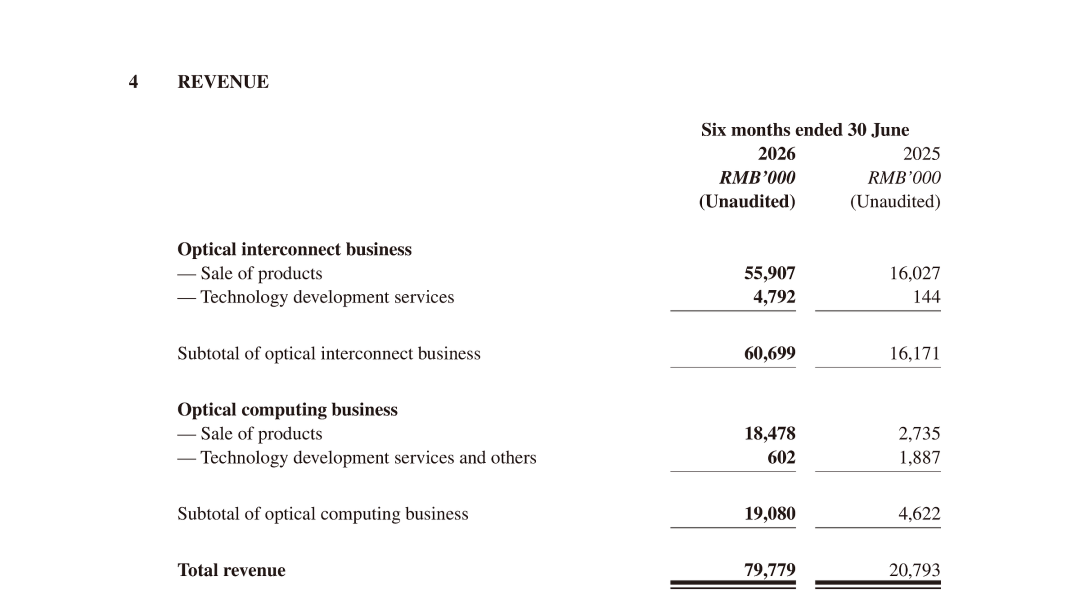
上半年,公司收入从去年同期的2079.3万元增至7977.9万元,同比增长284%。其中,光互连业务收入6069.9万元,占总收入的76.1%;光计算收入1908万元,占23.9%。

不过,284%的增速来自较低基数,公司也尚未盈利:剔除股份支付、金融工具公允价值变动和上市开支后,上半年经调整净亏损约1.47亿元。本文所说的“先卖起来”,指光互连率先形成了较大收入,并不是公司已经赚到利润。

一家以“光计算”进入公众视野的公司,为什么最先增长起来的却是光互连?

这个变化背后,是一道正在变得越来越重要的产业问题:GPU(图形处理器,也是大模型训练和推理的主力芯片)越来越多、单卡越来越快以后,数据还能不能及时送到下一颗GPU?

当答案开始变得不确定,AI算力的瓶颈也就从“计算得够不够快”,逐渐延伸到了“数据能不能跟上”。

01 GPU越快,等待数据的代价越高
过去看一台电脑的性能,我们习惯先看处理器。

但大模型的计算早已不是一颗GPU独立完成的。一个任务会被拆到几十、几百,甚至更多GPU上。每颗GPU完成自己的部分后,还要与其他GPU交换参数、计算结果和下一步需要的数据。

这就像一群速度越来越快的工人共同装配一件产品。每个人手上的动作都很快,但零件如果送不到,整条生产线仍然会停下来等待。

GPU也是如此。

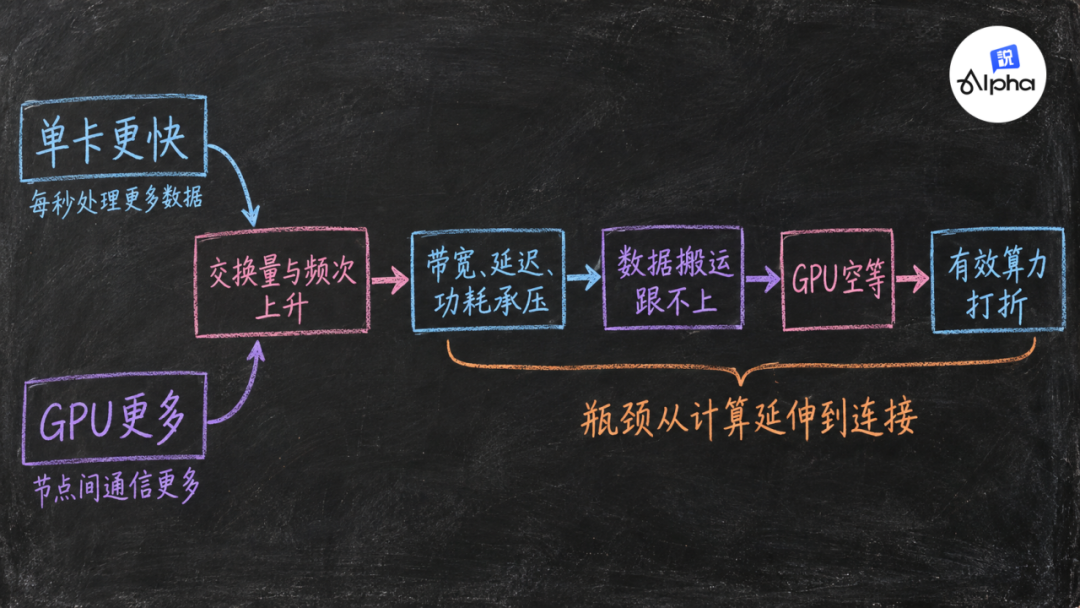
单卡性能提高,意味着一颗GPU在相同时间内可以处理更多数据,也需要更快地接收和发送数据;GPU数量增加后,需要同步的数据量、参与通信的设备数和调度难度也会随之上升。

在网络没有同步升级的情况下,一颗GPU算得越快,等待数据造成的损失就越大。

因此,AI基础设施真正要交付的,已经不只是芯片参数里的峰值算力,而是整个集群可以持续输出多少有效算力。

英伟达公布的第六代NVLink(英伟达用于GPU之间高速通信的专用互连)把每颗GPU的双向互连带宽提升到3.6TB/s,是上一代的两倍;一个72颗GPU组成的机架,总互连带宽达到260TB/s。英伟达披露的后续路线图还计划继续扩大高速互连域,并引入光连接。

这些数字说明,GPU的升级已经不能只靠GPU本身完成。芯片越快、集群越大,网络越需要和计算一起升级。

计算能力的提升,正在反过来把网络推到AI基础设施的中心。

02 光不是替代所有连接,而是进入原有方式开始承压的地方

GPU之间原本就有连接。为什么现在需要光?

关键不只是速度,还有距离、功耗和连接密度。

在较短距离内,铜连接成本低、延迟小,仍然有自己的优势。但随着传输速率提高,电信号在铜线和电路板上的损耗会迅速增加。为了让信号继续传得准确,系统需要加入更多补偿和处理器件,功耗和复杂度也随之上升。

到了跨服务器、跨机柜的距离,越来越多数据已经需要通过光来传输。

但传统的可插拔光模块也不是终点。现在的做法,是让芯片先把高速电信号送到设备面板上的光模块,再由光模块转换成光信号。芯片速度继续提高后,这一小段电信号走过的距离,也会带来损耗和功耗。
所以,光正在一步步向计算芯片靠近。

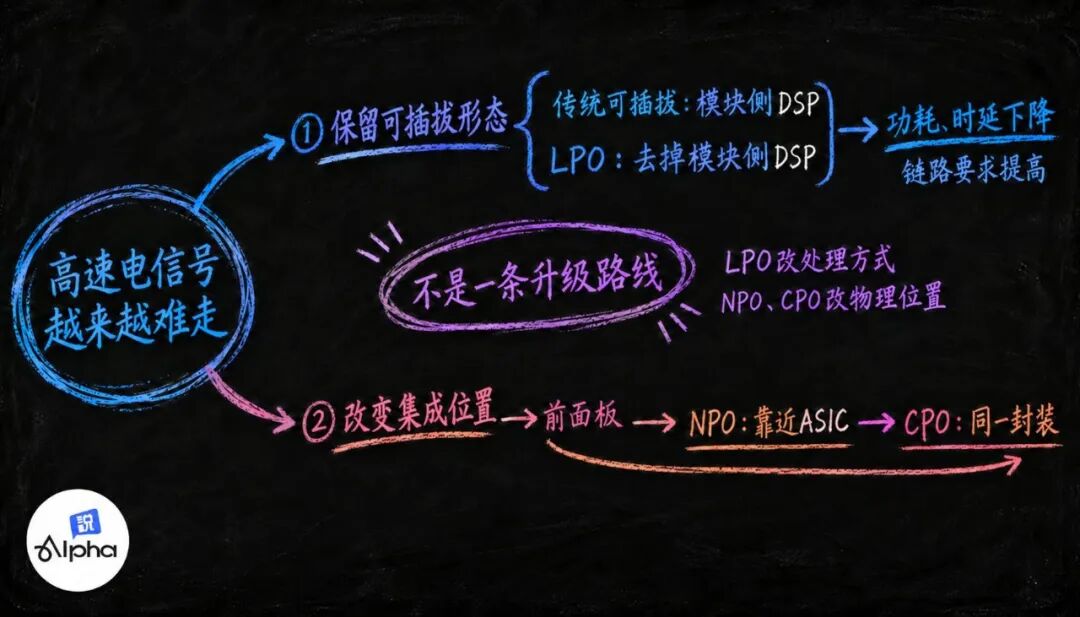
LPO(Linear Pluggable Optics,线性可插拔光模块)仍插在设备前面板上,但去掉模块里的DSP(Digital Signal Processor,数字信号处理器),把更多信号补偿交给主机侧芯片。

NPO(Near-Packaged Optics,近封装光学)把光引擎放到ASIC(Application-Specific Integrated Circuit,专用集成电路;这里通常指交换芯片)附近;CPO(Co-Packaged Optics,共封装光学)则进一步把光引擎和主芯片集成在同一封装基板上。

它们都在降低高速电互连的损耗和功耗,但路径不同:LPO改变模块内部的信号处理方式,NPO和CPO则通过改变光引擎的位置来缩短电通道。它们不是一条简单的顺序升级路线。

OCS(Optical Circuit Switch,光电路交换)解决的是另一个问题。它可以直接切换光路,让不同GPU组之间的连接根据任务重新组合。

它并不等于全面取代电交换。电交换擅长处理细小、频繁变化的数据包,光交换更适合承接稳定、持续时间较长的大流量连接。两者更可能在同一套AI集群里分工。

因此,这一轮变化不是简单地“用光纤换掉铜线”,而是光开始从机柜之间的数据通道,继续向交换设备、芯片封装和GPU计算域内部移动。

03 曦智科技先从连接获得收入,是一个怎样的信号?

把这条变化放回曦智科技,中报里的收入结构就更容易理解了。

曦智科技同时布局光计算和光互连。光计算试图改变数据由什么器件完成计算,光互连解决的则是数据怎样在GPU、服务器和机柜之间移动。

前者需要新的软硬件生态和应用方式,后者面对的是已经出现的集群瓶颈。

2026年上半年,曦智光互连业务收入同比增长275%。其中,5590.7万元来自Scale-up产品。Scale-up指把更多GPU放进同一个高速互连域,让它们像一个更大的计算单元共同工作。

公司披露,这一增长主要来自LightSphere X超节点方案的商业部署、其他客户新增的OCS订单,以及OCS产品定价提高。

与此同时,下一代产品仍处在不同阶段:NPO已经提供硬件样品并在客户侧验证;CPO交换机原型进入工程验证;部分800G、1.6T收发器光子集成芯片(PIC)仍在模块测试或设计迭代。

最先进入收入的,是今天已经需要解决的问题;还在测试和开发的,则对应下一阶段可能出现的连接方式。

不过,这份中报还没有把收入背后的客户完整展开。

四名未披露名称、且各自贡献超过10%收入的客户,合计贡献6190.6万元,约占总收入的77.6%。

我们暂时无法从公告中看清,这些客户分别购买了哪些产品,后续能否按期回款,是一次项目交付还是持续采购,以及相同方案能否进入更多客户。

所以,7977.9万元收入能说明曦智的产品和方案正在增加交付,但还不足以判断这些需求是否已经形成稳定、分散并且能够持续复制的商业结构。接下来更值得看的,是回款、复购和客户扩展。

但曦智提供了一个理解产业变化的入口。

过去,算力产业最稀缺的是GPU。谁能拿到更多、更快的芯片,谁就拥有更强的计算能力。

现在,GPU依然重要,但只有把大量GPU有效连接起来,芯片上的峰值性能才能变成可以使用的算力。

这会让AI集群的新增预算和系统价值,更多流向高速互连、光交换、硅光芯片、先进封装和网络调度。

与此同时,铜连接、电交换和可插拔光模块也不会突然消失,它们会在不同距离、成本和应用条件下继续演进。

真正发生的变化是:网络不再只是计算设备之外的配套,它正在成为计算系统本身。

GPU继续变快,也会继续产生更多需要搬运的数据。下一轮AI基础设施的竞争,不仅是谁拥有更强的芯片,还包括谁能让成千上万颗芯片少一点等待,真正一起工作。

本文为转载内容,授权事宜请联系原著作权人。

评论

暂无评论哦,快来评价一下吧!

下载界面新闻

微信公众号

微博

曦智科技收入增长284%,为什么先卖起来的是光互连?

算力堵在路上。

文|Alpha说

曦智科技刚刚交出上市后的第一份中报。

上半年,公司收入从去年同期的2079.3万元增至7977.9万元,同比增长284%。其中,光互连业务收入6069.9万元,占总收入的76.1%;光计算收入1908万元,占23.9%。

不过,284%的增速来自较低基数,公司也尚未盈利:剔除股份支付、金融工具公允价值变动和上市开支后,上半年经调整净亏损约1.47亿元。本文所说的“先卖起来”,指光互连率先形成了较大收入,并不是公司已经赚到利润。

一家以“光计算”进入公众视野的公司,为什么最先增长起来的却是光互连?

这个变化背后,是一道正在变得越来越重要的产业问题:GPU(图形处理器,也是大模型训练和推理的主力芯片)越来越多、单卡越来越快以后,数据还能不能及时送到下一颗GPU?

当答案开始变得不确定,AI算力的瓶颈也就从“计算得够不够快”,逐渐延伸到了“数据能不能跟上”。

01 GPU越快,等待数据的代价越高

过去看一台电脑的性能,我们习惯先看处理器。

但大模型的计算早已不是一颗GPU独立完成的。一个任务会被拆到几十、几百,甚至更多GPU上。每颗GPU完成自己的部分后,还要与其他GPU交换参数、计算结果和下一步需要的数据。

这就像一群速度越来越快的工人共同装配一件产品。每个人手上的动作都很快,但零件如果送不到,整条生产线仍然会停下来等待。

GPU也是如此。

单卡性能提高,意味着一颗GPU在相同时间内可以处理更多数据,也需要更快地接收和发送数据;GPU数量增加后,需要同步的数据量、参与通信的设备数和调度难度也会随之上升。

在网络没有同步升级的情况下,一颗GPU算得越快,等待数据造成的损失就越大。

因此,AI基础设施真正要交付的,已经不只是芯片参数里的峰值算力,而是整个集群可以持续输出多少有效算力。

英伟达公布的第六代NVLink(英伟达用于GPU之间高速通信的专用互连)把每颗GPU的双向互连带宽提升到3.6TB/s,是上一代的两倍;一个72颗GPU组成的机架,总互连带宽达到260TB/s。英伟达披露的后续路线图还计划继续扩大高速互连域,并引入光连接。

这些数字说明,GPU的升级已经不能只靠GPU本身完成。芯片越快、集群越大,网络越需要和计算一起升级。

计算能力的提升,正在反过来把网络推到AI基础设施的中心。

02 光不是替代所有连接,而是进入原有方式开始承压的地方

GPU之间原本就有连接。为什么现在需要光?

关键不只是速度,还有距离、功耗和连接密度。

在较短距离内,铜连接成本低、延迟小,仍然有自己的优势。但随着传输速率提高,电信号在铜线和电路板上的损耗会迅速增加。为了让信号继续传得准确,系统需要加入更多补偿和处理器件,功耗和复杂度也随之上升。

到了跨服务器、跨机柜的距离,越来越多数据已经需要通过光来传输。

但传统的可插拔光模块也不是终点。现在的做法,是让芯片先把高速电信号送到设备面板上的光模块,再由光模块转换成光信号。芯片速度继续提高后,这一小段电信号走过的距离,也会带来损耗和功耗。

所以,光正在一步步向计算芯片靠近。

LPO(Linear Pluggable Optics,线性可插拔光模块)仍插在设备前面板上,但去掉模块里的DSP(Digital Signal Processor,数字信号处理器),把更多信号补偿交给主机侧芯片。

NPO(Near-Packaged Optics,近封装光学)把光引擎放到ASIC(Application-Specific Integrated Circuit,专用集成电路;这里通常指交换芯片)附近;CPO(Co-Packaged Optics,共封装光学)则进一步把光引擎和主芯片集成在同一封装基板上。

它们都在降低高速电互连的损耗和功耗,但路径不同:LPO改变模块内部的信号处理方式,NPO和CPO则通过改变光引擎的位置来缩短电通道。它们不是一条简单的顺序升级路线。

OCS(Optical Circuit Switch,光电路交换)解决的是另一个问题。它可以直接切换光路,让不同GPU组之间的连接根据任务重新组合。

它并不等于全面取代电交换。电交换擅长处理细小、频繁变化的数据包,光交换更适合承接稳定、持续时间较长的大流量连接。两者更可能在同一套AI集群里分工。

因此,这一轮变化不是简单地“用光纤换掉铜线”,而是光开始从机柜之间的数据通道,继续向交换设备、芯片封装和GPU计算域内部移动。

03 曦智科技先从连接获得收入,是一个怎样的信号?

把这条变化放回曦智科技,中报里的收入结构就更容易理解了。

曦智科技同时布局光计算和光互连。光计算试图改变数据由什么器件完成计算,光互连解决的则是数据怎样在GPU、服务器和机柜之间移动。

前者需要新的软硬件生态和应用方式,后者面对的是已经出现的集群瓶颈。

2026年上半年,曦智光互连业务收入同比增长275%。其中,5590.7万元来自Scale-up产品。Scale-up指把更多GPU放进同一个高速互连域,让它们像一个更大的计算单元共同工作。

公司披露,这一增长主要来自LightSphere X超节点方案的商业部署、其他客户新增的OCS订单,以及OCS产品定价提高。

与此同时,下一代产品仍处在不同阶段:NPO已经提供硬件样品并在客户侧验证;CPO交换机原型进入工程验证;部分800G、1.6T收发器光子集成芯片(PIC)仍在模块测试或设计迭代。

最先进入收入的,是今天已经需要解决的问题;还在测试和开发的,则对应下一阶段可能出现的连接方式。

不过,这份中报还没有把收入背后的客户完整展开。

四名未披露名称、且各自贡献超过10%收入的客户,合计贡献6190.6万元,约占总收入的77.6%。

我们暂时无法从公告中看清,这些客户分别购买了哪些产品,后续能否按期回款,是一次项目交付还是持续采购,以及相同方案能否进入更多客户。

所以,7977.9万元收入能说明曦智的产品和方案正在增加交付,但还不足以判断这些需求是否已经形成稳定、分散并且能够持续复制的商业结构。接下来更值得看的,是回款、复购和客户扩展。

但曦智提供了一个理解产业变化的入口。

过去,算力产业最稀缺的是GPU。谁能拿到更多、更快的芯片,谁就拥有更强的计算能力。

现在,GPU依然重要,但只有把大量GPU有效连接起来,芯片上的峰值性能才能变成可以使用的算力。

这会让AI集群的新增预算和系统价值,更多流向高速互连、光交换、硅光芯片、先进封装和网络调度。

与此同时,铜连接、电交换和可插拔光模块也不会突然消失,它们会在不同距离、成本和应用条件下继续演进。

真正发生的变化是:网络不再只是计算设备之外的配套,它正在成为计算系统本身。

GPU继续变快,也会继续产生更多需要搬运的数据。下一轮AI基础设施的竞争,不仅是谁拥有更强的芯片,还包括谁能让成千上万颗芯片少一点等待,真正一起工作。

本文为转载内容,授权事宜请联系原著作权人。