
硅光芯片以光子替代电子完成信息传输与计算,天然具备高带宽、低延迟、低功耗的物理优势,正被视为突破AI算力与能耗瓶颈的重要技术路径。然而随着大模型参数规模和推理需求持续增长,硅光芯片产业化的关键已不只是追求更高的峰值算力,更在于实现算力提升与能效优化的同步突破。在这样的背景下,光本位科技推出的256×256光计算芯片,为其提供了全新的解题思路。
光本位科技正式发布256×256光计算芯片
2024年6月,光本位科技成功流片全球首颗达到商用标准的128×128光计算芯片,时隔两年,公司再次刷新行业纪录——在2026年WAIC生态展上,光本位科技正式发布256×256光计算芯片。
256×256光计算芯片是目前全球矩阵规模最大的全可编程光计算芯片,可在单颗晶粒上集成65000多个光计算单元。光本位科技开创性地将存储和计算融合于同一光学通路,AI大模型参数可直接存储在光计算芯片内部,无需在外部存储与计算单元之间频繁传输,大幅提升AI计算效率,并实现模型权重静态保持功耗为零。
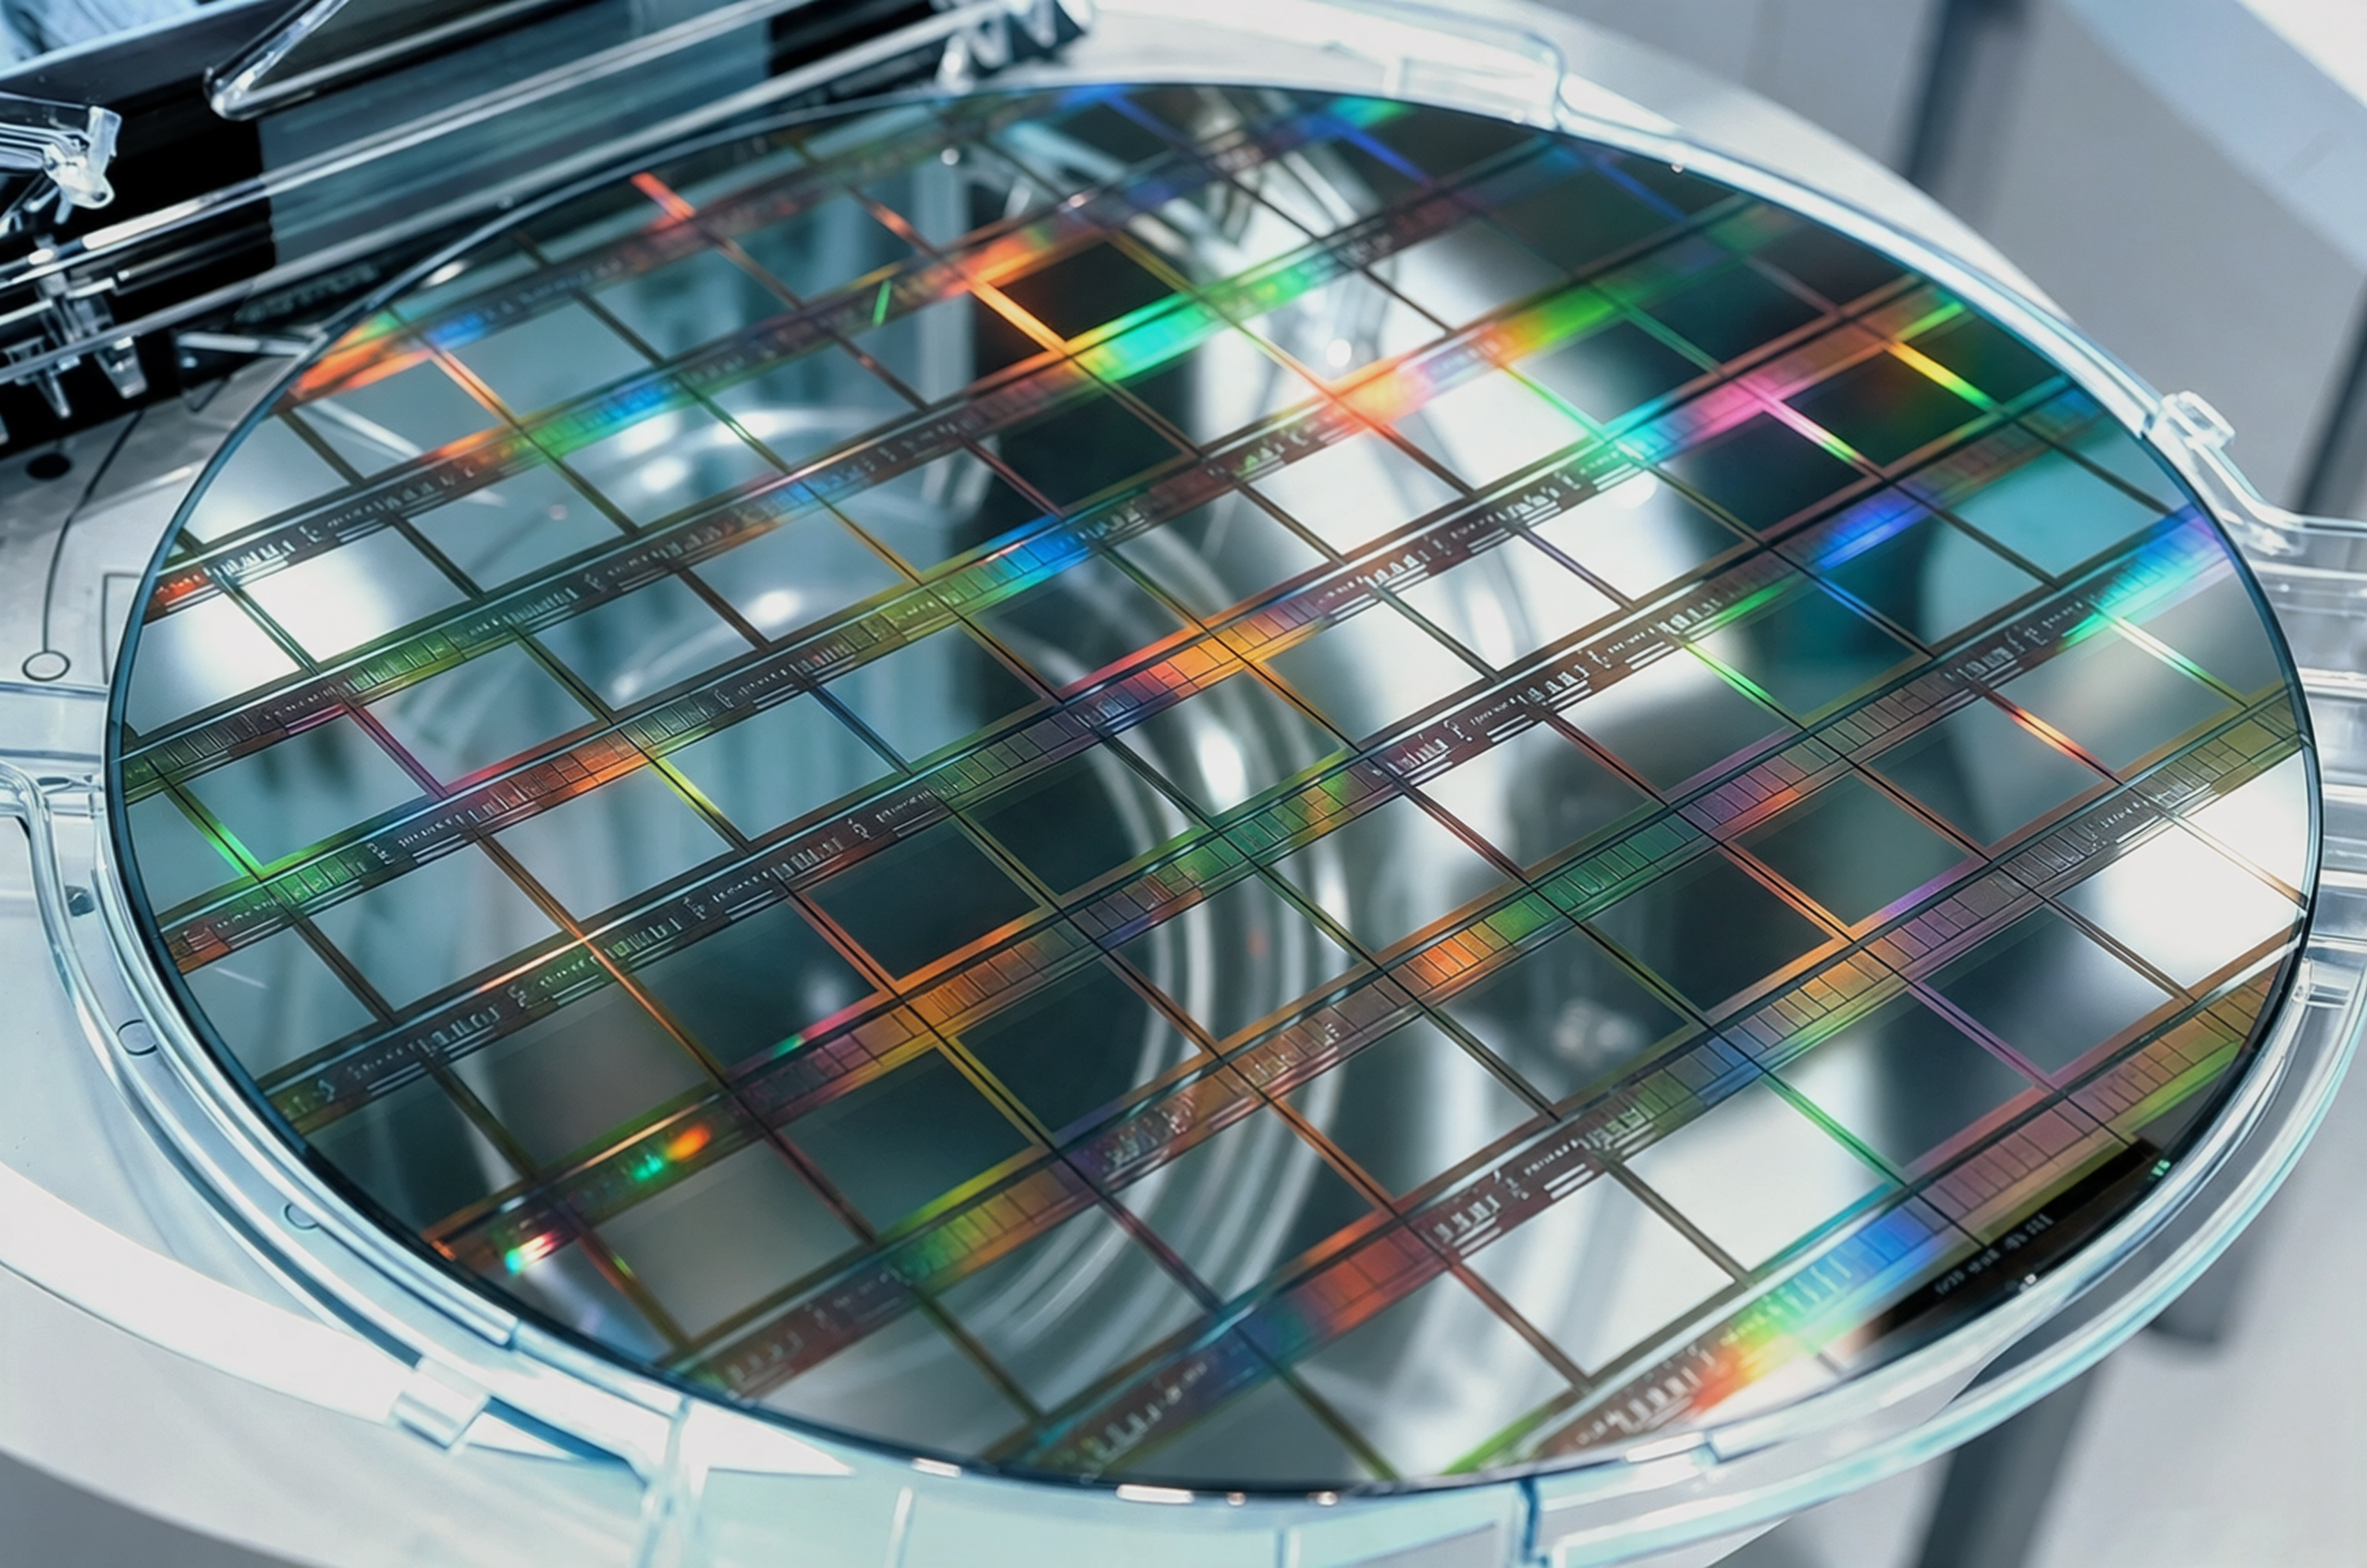
算力跃迁:从百TOPS到千TOPS
基于256×256光计算芯片,光本位科技年内将推出第二代光电融合计算卡。据公开信息,第二代光电融合计算卡的单卡算力将从第一代的百TOPS级跃升至千TOPS级,综合性能可对标国际主流AI推理GPU。
同时在能效表现上,光计算展现出显著优势——经测算,若算力中心大规模部署光本位科技的光电融合计算卡,整体年耗电量有望降至现有方案的1%左右,为绿色算力基础设施提供了可行的新型技术方案。
从实验室到产业:商业化加速落地
技术突破之外,光本位科技的商业化进程同样引人注目。目前,公司光计算产品已服务头部科技大厂、垂类AI公司、智算中心等不同类型的数十家客户,已完成10余个光计算系统的规模化交付,并获得数亿元人民币订单及意向协议,推动硅光芯片从性能突破加速迈向规模化应用。
此外,公司已与百度智能云达成战略合作,联合推出针对于光电芯片开发流程的全栈 AI 研发解决方案Lightmate,覆盖数字芯片、模拟芯片、光芯片设计及底层驱动开发全链路,以 AI Agent 为技术核心重构光计算芯片研发流程。同时,光本位科技还作为重点参与企业与中国移动联合发布了《面向新型智算的光计算技术白皮书》和《面向大规模智算集群场景光互连技术白皮书》,系统性地阐述了光计算和光互连技术在超大规模智算中心中的架构演进、技术路线、产业生态及标准化方向。
矩阵规模从128×128到256×256,单卡算力从百TOPS到千TOPS,应用场景从地面到太空,光本位科技正以一系列里程碑式的突破,推动硅光芯片从性能突破加速迈向规模化应用。正如公司愿景“为能源和智能的可持续性繁荣构建必要的芯片和系统基础设施”。当AI算力需求持续攀升、能效革命迫在眉睫,光计算或将给出一个答案。
(免责声明:本文为本网站出于广告目的进行转载发布,不代表本网站的观点及立场。本文所涉文、图、音视频等资料之一切权力和法律责任归材料提供方所有和承担。本网站对此咨询文字、图片等所有信息的真实性不作任何保证或承诺,亦不构成任何购买、投资等建议,据此操作者风险自担。)
评论