
烧烤机器人第一次抓调料瓶,没有拿稳。它停了一下,又试了一次,这次成功了。之后几次抓取,动作越来越稳定。
这是9月16日乐享科技在上海一场户外直播里的画面。搭载全新以太大模型的机器人在真实环境中连续作业约一小时,完成点单、烧烤、上菜等完整流程。按照乐享科技的说法,全程没有遥操、没有剪辑,也没有预设脚本。
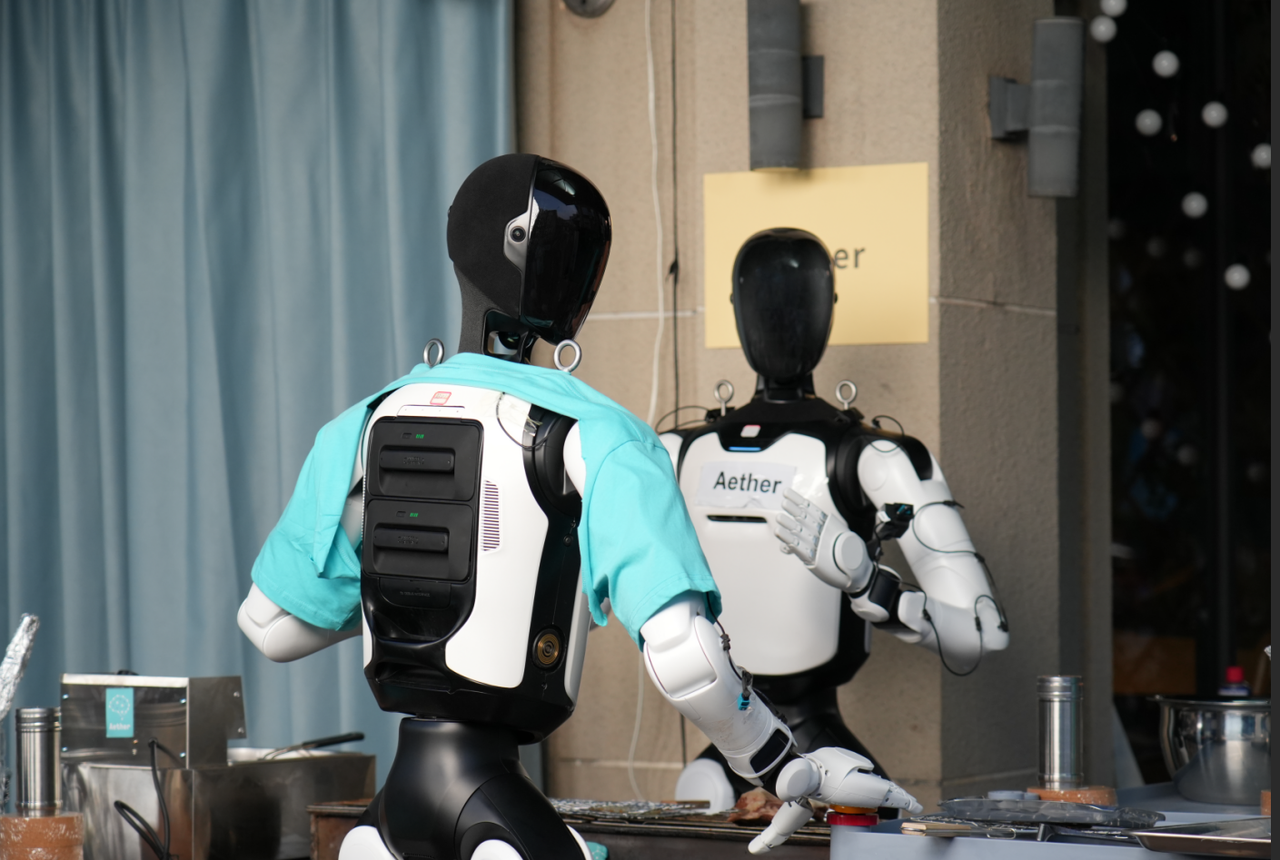
比起一条剪掉所有失误的Demo,这场直播最直观的特点,恰恰是失败没有被藏起来。机器人会停顿,会抓空,也会遇到计划之外的情况,而这些过程被直接暴露在在场30位行业媒体和超过550万线上观众面前。
现场6名顾客也不是来配合机器人的。乐享没有给他们任何预设任务,顾客可以临时改单、追加需求、移动物品位置,甚至主动打断机器人正在执行的任务。原定一名顾客临时未能到场后,现场直接从围观人群中随机找了一位补位,没有因此暂停流程。
CEO郭人杰还在直播中让摄像机穿过后厨、拍摄周边环境,以证明现场不存在遥操作空间。按照他的介绍,这块场地也是几天前才临时敲定,准备时间并不充裕。镜头不算精致,人员会临场反应,机器人也会犯错,这种甚至有些“草台班子”式的直播,反而获得了不少业内人士的正面评价:至少乐享没有试图把机器人包装成一台永远不会出错的机器。
但这场直播抛给行业的“深水炸弹”,不是“有没有遥操”,也不是“是不是造假”。而是当预设条件被拿掉之后、当不断的产生干扰和挑战时机器人靠什么继续把任务做下去。
问题从“这场直播是不是真的”,进一步变成了:什么样的模型架构,才能让机器人在计划不断失效的情况下继续判断、调整和行动?这也正是理解以太大模型技术路线的入口。
01 VLA、WAM,以及以太大模型的不同答案
过去两年,具身智能行业围绕“机器人到底应该怎样获得智能”,已经分出了几条不同路线。
VLA是其中最主流的一条。视觉、语言和机器人自身状态进入模型,最终生成动作,它首先解决的是“看到这个场景、接到这个任务,下一步应该怎么做”。
2026年,WAM以及更广义的世界模型路线明显升温。英伟达机器人方向负责人Jim Fan甚至曾用一句极具传播力的“VLA已死,WAM当立”,来概括这一变化。它背后的逻辑是:机器人不能只知道下一步做什么,还应该预测动作发生以后,世界会怎样变化。
VLA把重点放在动作生成,WAM进一步把世界变化纳入预测。但在乐享科技看来,当机器人真正进入物理世界以后,这两个问题之外,还有第三个问题:预测出来的动作和未来,最终能不能被一副具体的身体真正实现?
一个杯子的重量增加一倍,同样的抓取动作需要不同的关节力矩;杯子里装着液体,运动过程中重心还在不断变化;摩擦、接触、滑动、物体形变,也都会让原本合理的动作产生不同结果。
VLA容易停留在“不懂因果”,传统WAM则可能出现“可生成、不可执行”。
这当然是一种带有技术路线立场的判断,但它指向的是同一个问题:机器人最终面对的,不只是动作和未来画面,而是一个会持续反作用于自身的物理世界。
因此,以太大模型没有继续把“下一步动作是什么”或者“下一帧世界是什么”作为系统唯一的中心,而是把问题换成了另一种形式:当现实不断发生变化时,模型自己应该怎样跟着变化?这就是“能量驱动”这条路线真正开始的地方。
02 能量驱动,补上“真实世界”这一环
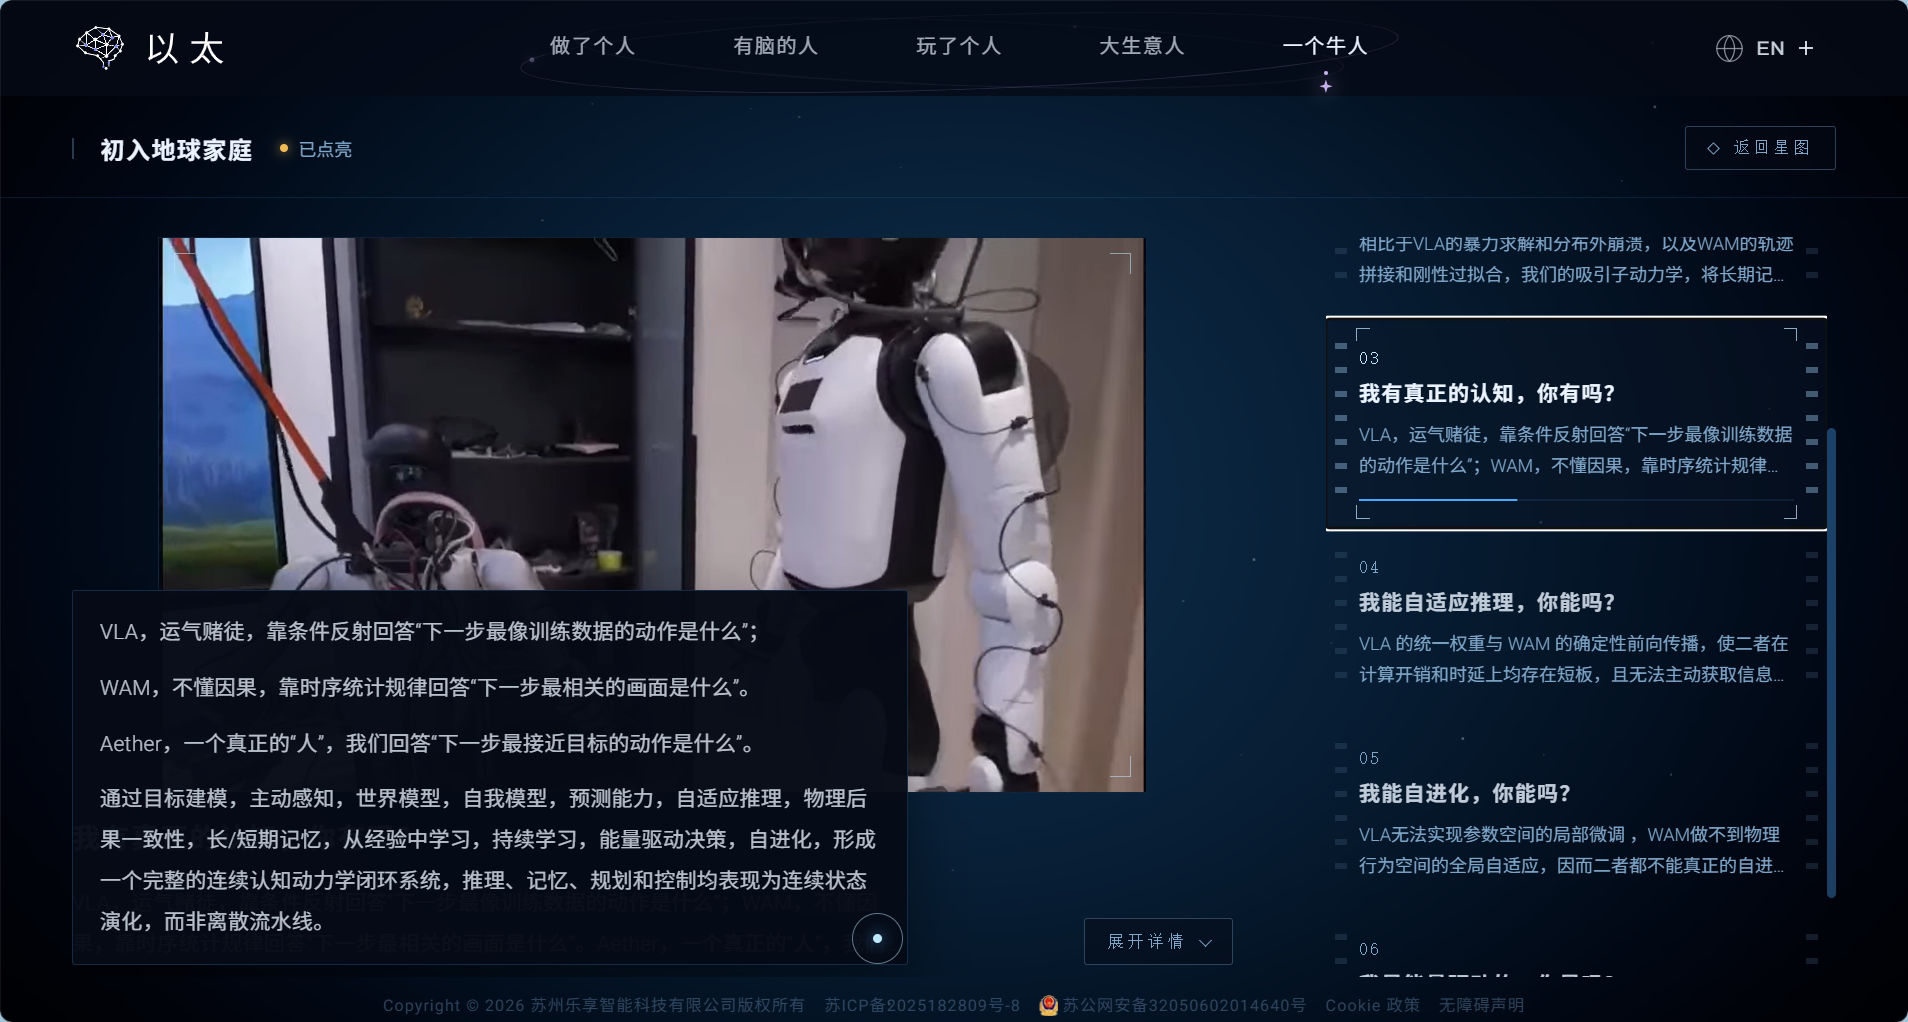
以太大模型所谓的能量更接近一张贯穿系统的“状态地形”:世界当前是什么状态,机器人自身处于什么状态,任务距离目标还有多远,哪些信息仍然缺失,都会进入同一套机制,共同影响系统下一步往哪个方向演化。
关键在于,这套机制并不只是评价“现在好不好”,还会持续驱动模型内部状态、连接和信息获取方式发生调整。
换句话说,机器人每做出一个动作,真实世界给出的结果都会重新进入模型。
烧烤机器人第一次抓调料瓶没有拿稳,之后的动作会随反馈调整;此前的室内Demo里,机器人先擦玻璃内侧,发现污渍仍然存在后,也没有继续机械重复原来的动作,而是重新改变观察和操作方式,判断污渍来自玻璃外侧,于是调整动作尝试处理玻璃外侧。
真正值得看的,不是机器人“会抓瓶子”或者“会擦玻璃”,而是现实结果与原有判断不一致以后,模型会不会因此改变自己的判断和及时修正行动。
这也让感知本身发生了变化。当已有信息不足以支撑下一步决策时,机器人需要处理的不只是“我现在看到了什么”,还包括“为了继续完成任务,我还需要看到什么”。改变视角、调整身体位置、主动获取更多信息,也都可能成为行动的一部分。
乐享将这种机制称为带有“感知意图”的主动感知。
但现实反馈能够改变当下判断,还只是第一步。Aether以太大模型所谓的“自进化”,更关键的是这些变化能不能进一步沉淀下来。按照以太大模型的机制,新的经验不会被无差别写进模型。系统会判断它是否可靠、是否足够新颖、能否明确归因,以及是否具有泛化价值,再决定哪些经验值得进入更长期的记忆、技能甚至模型参数。
这也是所谓“自进化”与普通临场调整真正拉开差别的地方:训练结束,并不意味着学习结束。
03 跨本体,智能不再被一副身体锁死
自进化再往前一步,考验的是泛化:学到的能力换一副身体以后,还能不能继续成立。
此前的室内Demo中,同一套以太大模型已经运行在两种不同品牌的机器人本体上;这次户外直播中,承担服务和烧烤任务的同样是不同形态的机器人,背后运行的也是同一套模型。
跨本体显然不只是换一套硬件接口。不同机器人在身高、自由度、关节能力和动力学约束上都不一样,同一个任务进入不同身体后,真正可行的动作方案也会不同。模型既要理解“任务要完成什么”,理解“这副身体的能力边界”,也要理解“当前这副身体到底能怎么完成”。
这背后对应的是以太大模型“脑—脊髓贯通”的仿生架构。上层负责意图理解、情景记忆、长任务规划和风险判断;中间层处理环境感知和任务状态;运动层负责动作规划、姿态平衡和误差修正;更靠近硬件的“脊髓层”,则处理力位控制、碰撞避让和防摔等需要快速响应的问题。
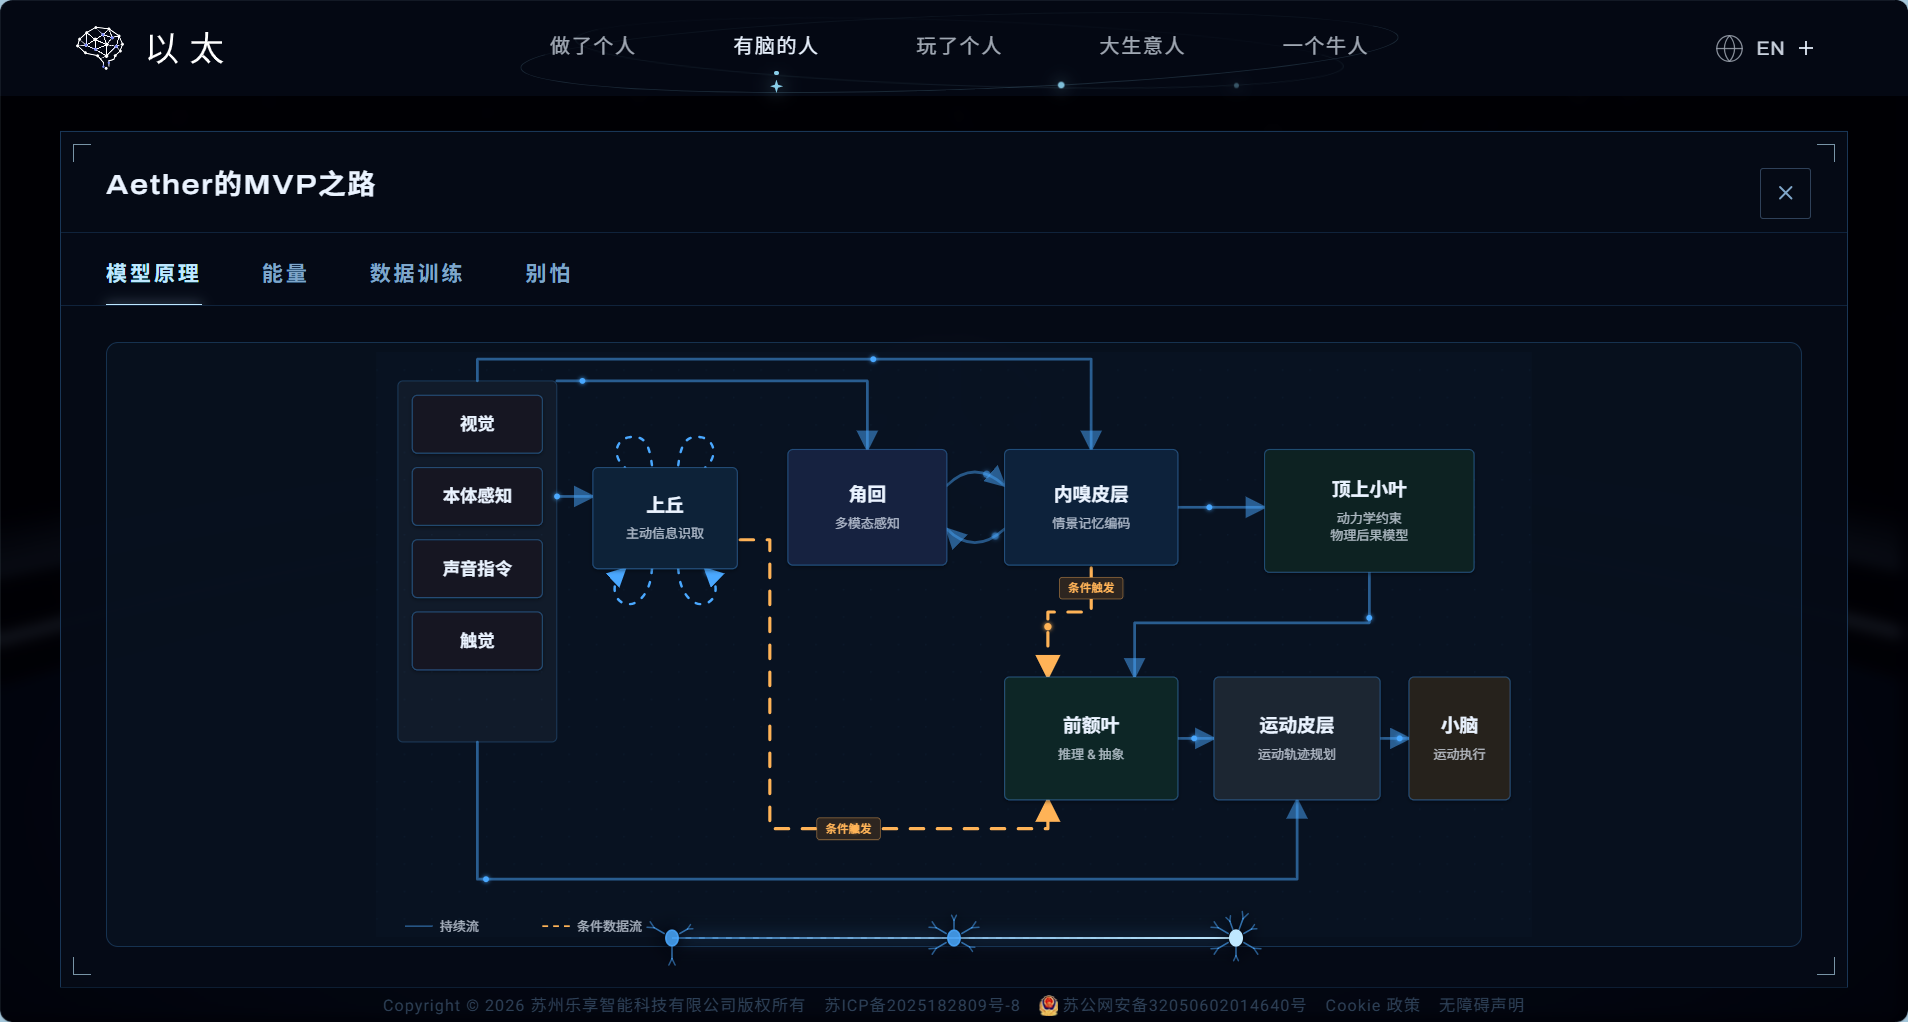
值得注意的是,这些层级不是彼此独立,而是像人类的逻辑和行为结构一样,协同一致。以太大模型让高层认知和底层身体控制形成一条连续的信息通路:任务目标向下进入身体,身体真正执行以后产生的物理反馈,再重新向上改变判断。
因此,跨本体追求的不是让不同机器人做出一样的动作,而是让同一个智能目标进入不同身体以后,都能找到与自身能力相匹配的实现方式。
直播里的双机协作,又把这个问题往前推进了一步。服务机器人完成点单后,会主动去找负责烧烤的机器人;等待时间变长后,也会再次确认进度。
两台机器人承担不同角色,却需要根据共同任务和对方状态持续调整自己的行为。跨本体因此不再只是“一个模型控制不同机器人”,而开始走向不同身体围绕同一个目标协同。
04 乐享让具身大模型性能,从“做得到”走向“持续成立”
一场1小时的户外直播,当然不足以证明一个模型已经获得了通用智能。真正值得讨论的,是它把一些过去很难在Demo里观察的问题直接暴露了出来。
过去,Demo更擅长证明“机器人能做到什么”;这场直播暴露出来的,则是另一类问题:当环境和任务持续变化,这些能力还能不能继续成立。
此前,具身智能的性能很容易被压缩成几个数字:参数量、真机数据规模、标准任务成功率,或者一段Demo里完成了多少高难度动作。这些指标依然重要,但更多回答的是“模型能做到什么”。
而真实世界要求的是另一种能力:当条件持续变化、计划不断失效时,模型还能不能保持对任务的理解,并继续作出有效判断。
从这个角度看,以太大模型这次真正拿出来验证的,并不只是某一项新技能,而是一套更连续的能力链条:现实反馈能否改变下一步判断,短期调整能否进一步沉淀为经验,同一套智能换到不同身体之后是否依然成立。
这套能力最终能走多远,仍然需要更多场景和更长周期的验证。但至少,具身大模型的“性能”正在多出一层新的含义:不只是“做没做到”,还包括现实发生变化之后,能力还能不能持续成立。
这才是以太大模型真正想换掉的那把“性能标尺”。
评论