
当大模型进入高频迭代阶段,GPU的竞争逻辑正在发生变化。
过去,市场评价一款GPU,更多关注芯片架构、算力性能、显存容量以及能效比。但对于真正使用GPU的企业和开发者而言,硬件只是第一步:一款新模型发布之后,能否快速在GPU上运行、主流框架能否兼容、已有代码需要改多少、部署成本有多高,同样决定着一款GPU最终能否进入真实业务。
这意味着,GPU不再只是单一的硬件产品,软件生态能力正在成为放大GPU商业价值的重要变量。
在这一变化中,沐曦股份的实践颇具代表性。
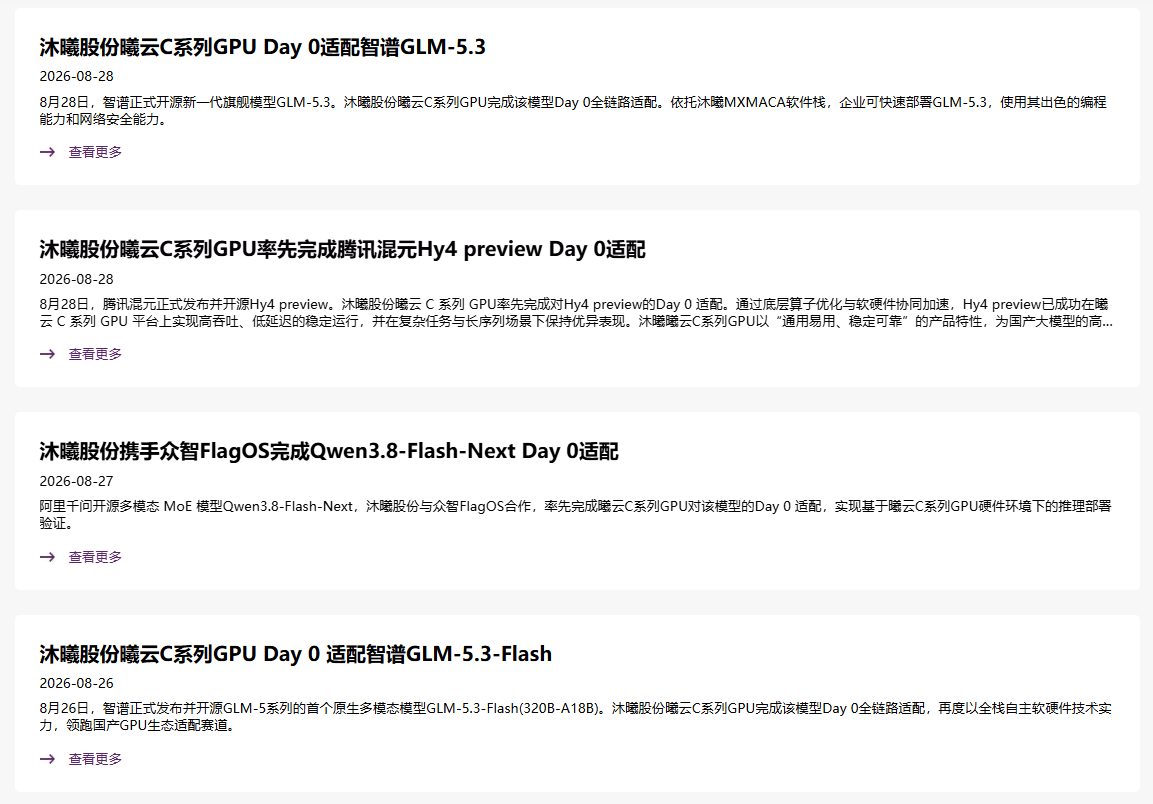
今年以来,沐曦股份持续通过自研MXMACA软件栈推进主流AI生态适配,并持续跟进最新大模型。截至9月20日,沐曦股份自2025年12月以来已经完成39个主流旗舰模型的Day 0适配,覆盖智谱、阿里千问、MiniMax、DeepSeek、阶跃星辰、腾讯混元等头部模型厂商。
从一个个模型的Day 0适配背后,可以看到国产GPU竞争正在从“芯片性能竞争”,逐渐延伸到“软硬协同和生态响应能力”的竞争。
GPU的商业价值,越来越取决于软件生态
GPU本身提供的是计算能力,但计算能力要转化成商业价值,还需要软件栈把硬件能力与模型、框架和应用连接起来。
对于企业客户而言,采购GPU并不是重新建立一套完全不同的软件体系。客户已有的大量模型、算法、开发工具和应用,都需要能够迁移到新的算力平台。
因此,迁移成本成为国产GPU商业化过程中一个绕不开的问题。
沐曦股份自研的MXMACA软件栈,正承担着连接GPU硬件与上层AI生态的作用。目前,MXMACA已经覆盖底层驱动、用户态接口、MXCC编译器、算子适配,以及主流训练和推理框架等多个层级,并支持40余种AI框架、1000多款模型以及6000多个开源项目测试,全量支持PyTorch 2.8的2410个GPU算子。
这意味着,沐曦股份所构建的软件能力,并不是简单地给GPU增加一个“驱动程序”,而是试图把GPU与整个AI开发生态连接起来。
对于客户而言,软件栈的兼容程度越高,原有模型和代码迁移所需要付出的改造成本就越低。
而对于GPU厂商而言,软件生态越完善,硬件能力越容易被开发者和企业真正使用。
为什么沐曦越来越强调“Day 0”?
如果说软件生态解决的是“能不能用”,那么Day 0解决的是“能不能及时用”。
这是大模型快速迭代之后出现的新问题。
以今年的模型生态为例,从MiniMax M2.7、M3,到腾讯混元系列模型,再到智谱GLM-5.3以及上海人工智能实验室ATRIA Dawn Preview,新模型持续发布。
沐曦股份几乎总在模型发布当天完成适配。
今年6月,MiniMax发布M3后,沐曦股份曦云C系列GPU完成Day 0适配;8月28日智谱开源GLM-5.3,沐曦曦云C系列GPU完成Day 0全链路适配;9月14日上海人工智能实验室开源ATRIA Dawn Preview,沐曦股份同日完成Day 0适配。
对于大模型而言,发布当天往往是开发者关注度最高的窗口。
如果GPU厂商需要等待数周甚至更长时间才能完成适配,开发者在这段时间内可能已经选择了其他算力平台。
因此,Day 0的意义并不只是“快”。
它背后考验的是GPU厂商的软件栈成熟度、工程团队响应速度,以及与模型厂商、操作系统和开源社区之间的协同能力。
从“适配一个模型”,到“适配整个AI生态”
沐曦股份39个Day 0适配案例背后,更值得关注的是其软件生态能力的延伸。
以最近的ATRIA Dawn Preview为例,沐曦股份并非简单完成模型运行,而是依托MXMACA覆盖驱动、编译器、算子和训练/推理框架等多个层级。
这种能力对于GPU商业化的重要性在于:
模型越多,框架越复杂,开发者越分散,单纯依靠硬件性能形成的优势就越难转化成真实的使用规模。
相反,如果软件栈能够保持对主流生态的高兼容,并且持续跟进最新模型,客户就可以在较低迁移成本下使用新的算力平台。
这也是沐曦股份近年来持续推进MXMACA生态建设的商业逻辑。
从这个角度看,MXMACA更像是沐曦GPU商业生态中的“连接器”和“倍增器”:一端连接曦云C系列等GPU产品,另一端连接不断变化的模型、框架和开发者生态。
软件生态最终还要回到商业化
当然,软件生态的价值最终还是需要通过真实应用来验证。
目前,沐曦股份的GPU产品已经进入多个智算中心和行业应用场景。与此同时,沐曦股份也在推进大规模国产算力集群建设,并不断拓展GPU在金融、医疗健康、能源、教科研、交通等行业的应用。
今年5月,沐曦曦云C600实现量产,并通过国家安全性及可靠性测评。9月7日举行的沐曦股份2026年半年度业绩说明会上,公司披露下一代曦云C700核心设计、功能验证已大部分完成,目前正在进行进一步性能调优。
这条产品路线,与软件生态实际上是相互支撑的。
硬件决定算力上限,软件决定算力能否被高效使用,而生态则决定这种能力能够覆盖多大的应用范围。
国产GPU竞争进入“软硬一体”阶段
从行业视角看,国产GPU已经逐渐走过单纯强调“芯片能不能做出来”的阶段。
当GPU开始进入智算中心和大模型训练、推理等真实场景后,客户关注的问题会更加具体:
能不能运行主流模型?
能不能兼容主流框架?
迁移需要多少工作量?
新模型发布后多久能够支持?
出现问题之后有没有开发者社区和技术支持?
这些问题最终都会落到软件生态。
因此,沐曦股份今年持续推进39个主流模型Day 0适配,以及MXMACA对40余种AI框架、1000多款模型和6000多个开源项目测试的覆盖,并不是两个孤立的数字。
它们共同指向一个趋势:
国产GPU的竞争正在从“硬件可用”走向“软硬一体、生态好用”。
而对于沐曦股份而言,如何继续通过MXMACA降低客户迁移成本、提高新模型响应速度,并进一步将软件生态转化为GPU产品的商业价值,可能会成为下一阶段值得持续观察的变量。
评论