


文|爱分析
基础模型与具身智能的边界正在变得模糊。在梁文锋的研发路线图中,具身智能被放在最后,但DeepSeek的投资布局已先行一步。
DeepSeek此前投资了宇树科技,如今又拟领投前腾讯混元多模态理解负责人胡瀚创办的Winverse AI。一家擅长机器人硬件和运动控制,另一家探索具身智能。DeepSeek的研发重心仍在基础模型,投资却已经伸向了物理世界。
这两件事并不矛盾。在梁文锋设想的路线中,先让AI具备持续学习、自我迭代的能力,再借助更强的AI去研发机器人,是更好的顺序。AI越擅长编程、推理,并能在研发过程中承担更多工作,进入具身领域时,就越有可能少走弯路。反过来,如果这些能力还不够,就得在机器人研发中花更多力气,一道一道地攻克难题。
所以,具身研发可以晚一点做,布局却可以先行。DeepSeek继续集中力量推进基础模型,同时通过投资,提前接触机器人硬件、研究人才和开发测试资源。等到真正下场时,未必需要从头追赶。
对具身厂商来说,这才是值得警惕的地方。未来的对手,可能是一个已经在基础模型上积累了更强能力、又提前做好准备的跨界者。它今天还是投资者和潜在伙伴,明天就可能与你争夺机器人的核心智能。
01 主攻通用AI,不误布局具身
要把AI带进物理世界,光有模型还不够。模型能不能理解眼前的环境、给出合适的动作,最后都得放到机器人上试。宇树能提供的,正是开展这些工作的基础。
人们熟悉宇树的机器狗和人形机器人,但它的产品还包括机械臂、灵巧手,以及关节、电机等关键部件,也提供相应的软件和开发接口。 对模型团队来说,这意味着不必先从造一台机器人开始,就能着手测试自己的想法。
测试又会带来新的问题。机械臂伸过去,会不会碰到东西?抓取的位置对了,为什么还是没抓稳?这些问题,有些出在模型,有些出在控制和硬件,需要放在一起反复调试。
宇树多年积累的机器人研发经验,在这里就有了价值。投资宇树,为DeepSeek接触这套硬件、工具和开发经验提供了入口。
Winverse连接的,则是另一类积累:如何让模型理解物理世界,并学会行动。
创始人胡瀚与DeepSeek也有研究上的渊源。他与DeepSeek研究员解振达曾共同参与SimMIM、Swin Transformer V2等研究,在视觉模型和大规模训练方面有过合作。 因此,这笔拟议投资既是在接触一个具身智能团队,也是在延续已有的研究联系。
两笔投资,先把硬件、人才和合作关系准备起来。DeepSeek把主要研发力量留在基础模型,同时保留了在具身领域继续深入的机会。
这套安排的好处在于,梁文锋不必现在就对两条路线的胜负下注。如果基础模型的进步能够带动机器人研发,DeepSeek有机会借助这些合作加快进入;如果具身仍需要长期独立探索,它也已经参与其中。主攻基础模型,与提前布局具身,可以同时进行。
02 从动作决策到训练体系的竞争
梁文锋的判断并不孤立,Anthropic首席执行官Dario Amodei有过相近设想。
在《Machines of Loving Grace》中,Amodei描绘的强大AI,可以没有自己的身体,却能通过计算机操作机器人和实验设备,甚至设计供自己使用的机器人。 两人的判断有一个重要交集:基础模型越强,不仅越有可能操纵机器人,也越能帮助人们把机器人研发出来。
Google已经沿着这个方向推进。它的Gemini Robotics体系,从理解物理环境、生成动作,到在机器人本地运行模型,都有相应布局。 这说明,通用模型公司较早就开始认真解决机器人怎么行动的问题。
OpenAI近期发布的GPT-6 Astra的表现,则让这种跨界变得更直观。在RoboDojo的一项研究中,研究人员向它提供图像、机器人状态和任务说明,让它决定机械臂下一步往哪里移动、调整到什么朝向,以及夹爪如何动作,再交给控制软件执行。
Astra没有针对这些评测任务专门微调,却在42项仿真任务、共2100次试验中,取得了22.48%的平均成功率;作为参照,同一研究中两款机器人策略模型,DM0.5和π0.5,分别为19.34%和6.91%。输入条件并不完全相同,但结果已经足以让具身厂商认真对待:基础模型开始在机器人动作决策上表现出竞争力。
决定机械臂下一步怎么动,原本就是具身模型要解决的核心问题。现在,基础模型也能参与争夺。
这种能力是怎么来的?一个容易产生的误解是,Astra原本只会处理数字世界里的任务,后来突然学会了操作机器人。实际上,评测时没有专门训练并不代表此前没学过相关内容,业内人士普遍认为Astra训练使用了大量机器人数据。
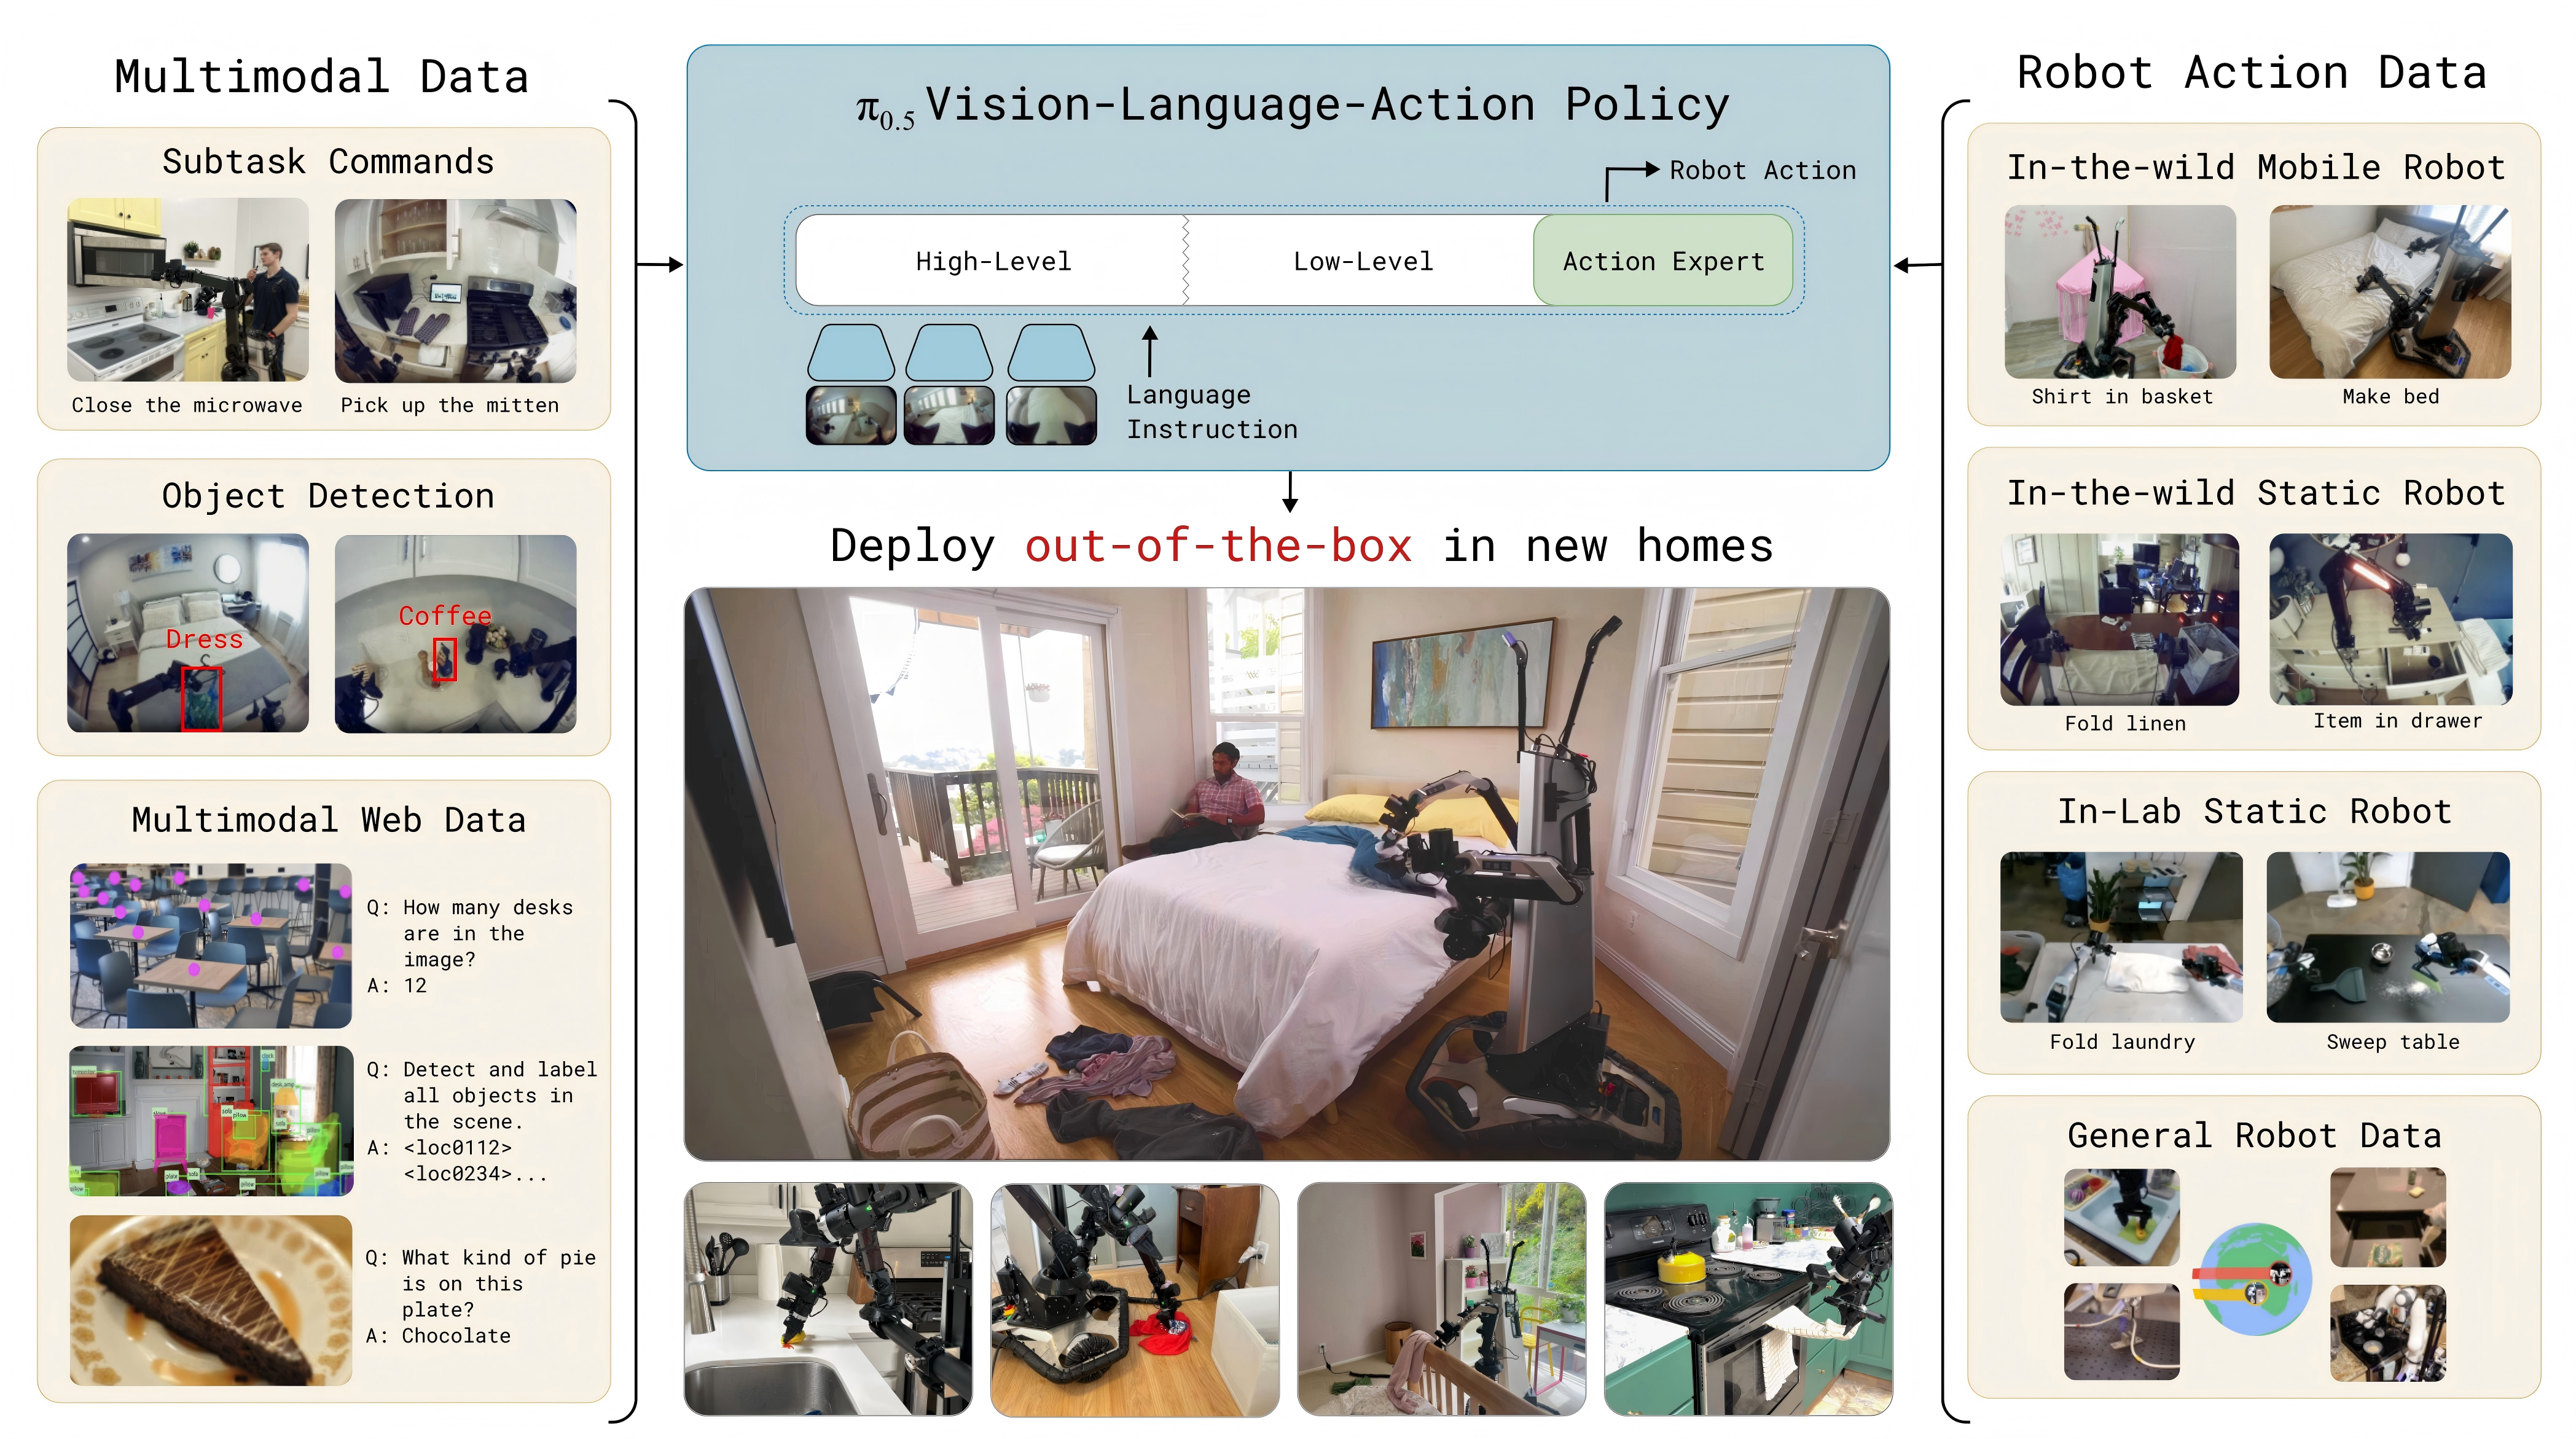
具身厂商Physical Intelligence(PI)做过一个实验,可以帮助理解这里的关系。它训练π0.5时,既用了机器人动作数据,也用了网络上的图文数据。在一项让机器人操作陌生物体的测试中,完整训练组合的子任务平均成功率是94%;去掉其中的网络图文数据后,成绩降到了74%。
教机器人干活,不一定只靠一遍遍示范动作。网络上的图文知识,也可能帮它更好地理解眼前的东西和人交代的任务,进而把活干好。
这就带来了一个新的竞争问题。过去,大家更关心谁采集的具身数据多、谁的动作训练做得好。现在,还得看谁能把这些数据与更广泛的知识结合起来。基础模型厂商多年积累的能力,可能恰好在这里派上用场。具身厂商当然也能采用这种方法,但它们需要面对的,已经是另一种规模和方式的竞争。
还有一条路径,更贴近梁文锋和Amodei的设想:让AI帮助研发机器人。
在前述研究的另一项实验中,Astra编写了控制灵巧手弹琴的程序,再根据仿真结果修改代码,参与控制方案的设计与调试。 这时,它承担的是一部分研究和开发工作。
更早的Eureka研究,也让GPT-4参与设计机器人的训练规则,告诉训练系统什么动作做得好、什么动作应该避免。后续的DrEureka又进一步,让语言模型设计仿真训练条件,帮助机器人把仿真里学到的技能用到现实中。
这些尝试还不能让AI包办机器人研发,但已经说明,编程、推理和调用工具的能力,可以进入机器人的开发流程。后来者借助更强的AI,可能更快写出控制程序、设计训练方案,并在仿真和测试中不断发现问题、调整方案。
梁文锋优先推进基础模型的战略意义也在这里:先提高AI解决研发问题的能力,再用它降低进入具身的难度。先行者积累多年的经验,也许会被后来者一捅就破。
03 具身厂商必须在基础模型层迎接挑战
当然,AI能帮忙写程序、设计训练方案,不等于机器人就能在现实中把活干好。
自变量创始人王潜提醒,基础模型厂商进入具身,同样要解决数据采集、仿真、评测和硬件等问题。 机器人碰到东西时如何调整力度,物体突然滑落时怎么反应,连续工作几个小时还能不能保持稳定,都需要在真实环境中反复摸索。
Astra就还面临一个很实际的问题:慢。
NVIDIA的Astranomy研究在仿真环境中测试Astra,并把模型生成动作时的等待时间计入测试过程。在直接生成动作的模式下,Astra每次推理调用平均耗时约18.56秒,其中包括网络延迟。
仿真环境可以停下来等待模型返回结果,现实世界却不会。机器人伸手接一个正在滑落的杯子,可没有十几秒留给它思考。
所以,实验中能完成任务,与现实中能及时、可靠地完成任务,还有距离。这段距离,正是具身厂商多年积累可能发挥作用的地方。
具身厂商也没有坐等基础模型追上来。Generalist选择从物理交互中训练自己的基础模型,希望机器人在接触和操作物体的过程中学到更通用的能力。 智元董事长邓泰华则把路线说得很直接:“先具身再智能,不是先智能再具身。”
这个顺序与梁文锋的选择不同。梁文锋希望先把基础模型做强,再用它降低机器人研发的难度;智元更强调先让机器人进入实际环境,在使用中积累经验,再推动智能提升。双方都想做出更强的模型,只是从不同的地方出发。
因此,把基础模型的进入简单看成一场全面的“降维打击”,低估了具身厂商正在做的事。它们同样在建设基础模型,也能利用基础模型改进训练和研发。
物理经验是具身厂商的优势,但入场早,不代表就能守住。关键是能否把积累的经验用来改进模型,让机器人学会新任务时少采数据、少做调试。做到这一点,才有底气迎战基础模型厂商。
04 守住核心智能,要么让出更多价值
Figure已经做过一次选择:结束与OpenAI的合作,转向自研。
在2026年4月底的一次访谈中,Figure创始人Brett Adcock解释,机器人训练、调试、修复和质量控制,需要放在一起配合推进,如果核心模型掌握在外部公司手里,这些工作就很难按自己的需要一起改进。
说到底,Figure不想让机器人的核心能力,受制于别人的模型。
但决定自己做,只是开始。如果机器人每学一个新任务,都要重新采一批数据,再由工程师反复调试,那么即使模型是自研的,也可能被后来者追上。真正的护城河,是把今天遇到的问题和积累的经验,变成明天更快学会新任务的能力。
具身厂商也可以利用基础模型来加快这个过程。AI能帮基础模型厂商写程序、做仿真、分析测试结果,同样也能帮具身厂商做这些事。已有的物理经验,与越来越强的AI工具结合起来,也可能让先行者跑得更快。
因此,这场竞争更可能让具身厂商走向分化。
一部分厂商会在基础模型上站住脚,与基础模型厂商争夺机器人的核心智能。另一部分厂商的长处,则可能留在硬件、系统集成和实际交付上。它们仍然可以成为优秀的机器人公司,只是机器人由谁制造、由谁赋予智能,未必再是同一个答案。最有价值的部分,也未必都留在具身厂商手里。
如果既做不出有竞争力的模型,硬件和交付又没有明显优势,日子就会难过。前面有基础模型厂商进入,旁边还有更强的具身同行,融资和入场早带来的优势,很难一直撑下去。
再回头看DeepSeek的布局,梁文锋给自己留下的选择就更多一些。内部继续主攻基础模型,外部提前接触具身人才、硬件和开发测试资源。无论是基础模型逐渐学会物理任务,还是基础模型与具身模型的训练进一步融合,DeepSeek都有机会参与。
这就是梁文锋的具身阳谋:研发可以有先后,布局不必等到最后。先把基础模型做强,再用更强的AI进入物理世界;与此同时,把可能需要的伙伴和条件提前准备起来。
对具身厂商而言,这样的对手更难应付。它可以与你合作,也可能把你正在攻克的任务,纳入自己的模型训练。等它真正下场时,带来的可能已经不只是资金,还有一套新的解题办法。
评论