
正在阅读:

算力文明06|AI变便宜,便宜在哪里?

扫一扫下载界面新闻APP

算力文明06|AI变便宜,便宜在哪里?

便宜要落到工作上。

文|Alpha说 Y

看到模型调用降价,我会先追问一句:便宜的是哪一段?

生成一份初稿的账单降了,核对初稿却仍要花时间;每百万Token(模型处理文本的片段)的报价降了,一项任务也可能因为反复重试而花得更多。要判断AI究竟便宜了多少,需要把“调用一次”与“完成一件事”放在不同的账上。

我理解的变化,是部分文字生成、分类、提取和分析任务,正在获得更低成本的执行方式。真正值得关注的,是在同样交付要求下,完成合格工作的总成本能否下降。

01 训练投入、运行成本和服务报价,是三笔账
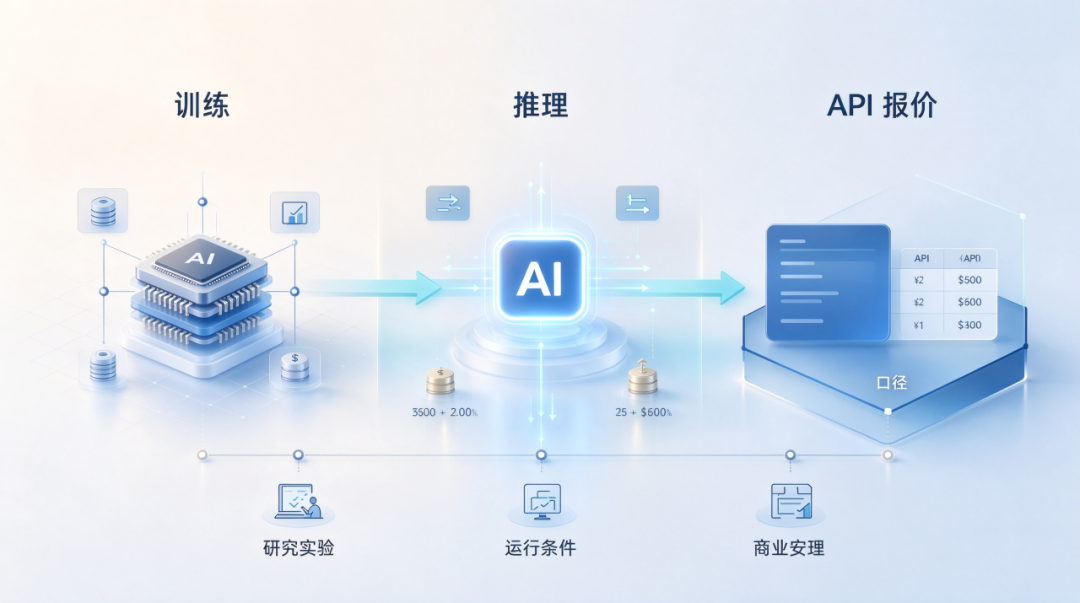
先看模型怎样被做出来。

训练模型,需要数据处理、计算资源和人员投入,也可能经历反复试验。讨论“训练成本”时,必须先明确范围:说的是某次正式训练所用的计算费用,还是包含前期研究、实验和其他开发工作的投入。

DeepSeek-V3技术报告就明确说明,其按假设租价折算的正式训练计算费用,不包括此前关于架构、算法或数据的研究与对比实验费用。一个披露数字,并不能自动代表模型从研究到上线的全部开支。

模型训练完成后,接收输入、生成回答的运行过程,通常称为推理。模型参数可以反复使用,每次服务仍需要计算、显存、网络和运行维护。能力可以复用,交付服务的容量仍然要付出成本。

推理的单位成本,也需要一个明确的分母。是处理一个Token、一条请求,还是完成一项任务?在怎样的模型、输入长度、并发和响应时间条件下计算?换了分母,数字就未必能直接比较。

API报价则是用户向服务商支付的价格。API可以理解为软件调用模型服务的接口。报价会受技术效率、竞争策略、套餐、优惠和商业安排等因素影响,不能仅凭价格表,反推出供应商的实际成本或利润。

因此,模型调用降价,并不意味着开发这个模型的成本按同样比例下降。一次免费调用,也不意味着背后的运行没有成本。

02 计算能搬多远,要看任务等不等得起
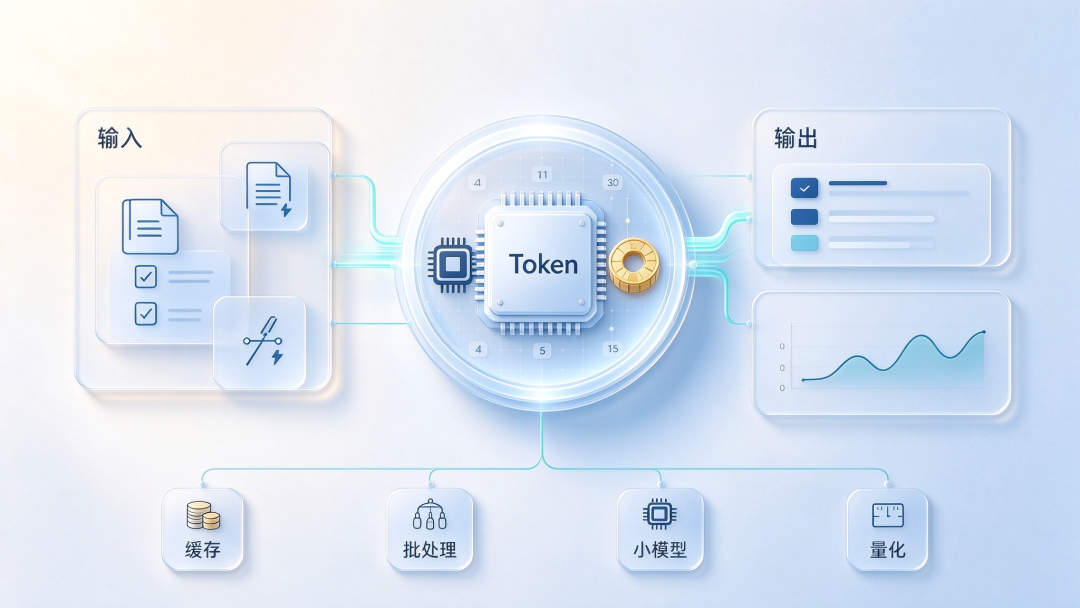
读价格表,先要看清输入和输出。

输入是交给模型的指令、材料及相关上下文;输出是模型生成的内容。两者可能分别计价,缓存输入、不同处理方式也可能使用不同费率。有些服务还对用于内部推理的Token计费。

Token是模型处理文本的片段,不等于固定数量的汉字。不同模型的切分方式也可能不同。比较“每百万Token多少钱”时,需要同时核对模型、输入输出、上下文条件和收费项目。

在这些边界内,有几种常见的降费办法。

一种是缓存。多个请求反复使用相同的长指令或材料前缀时,服务可以复用已经处理过的部分。以Claude的提示缓存为例,命中要求相应内容完全一致,并受最低长度、有效时间等条件限制。在这个服务中,写入缓存需要付费,费率还高于普通输入;如果有效期内复用不足,未必划算。

另一种是批处理。任务可以等待时,把多个请求交给批处理服务,可能取得不同于即时调用的报价。它适合不必立即拿到结果的工作,但要接受相应的完成时限、容量及失败处理条件。把实时服务改成等待交付,改变的不只是价格。

还可以选择更适合任务的小模型。固定格式提取与复杂开放分析,对能力的要求并不相同。如果较小模型已经通过本任务的验证,就有机会降低所需资源和费用。但模型更小,并不保证在每个任务上都更便宜、更可靠。

量化等优化,则通过改变数值表示等方式,减少部分存储或计算负担。能否节省实际费用,要看运行环境是否支持,以及优化之后的质量、速度是否仍然合格。

降费方法需要与任务匹配,报价优惠也不能一律当成底层成本下降。有时减少了重复处理,有时提高了运行效率,有时则只是服务商提供了不同的收费安排。

03 最后还要算,每个合格结果花了多少
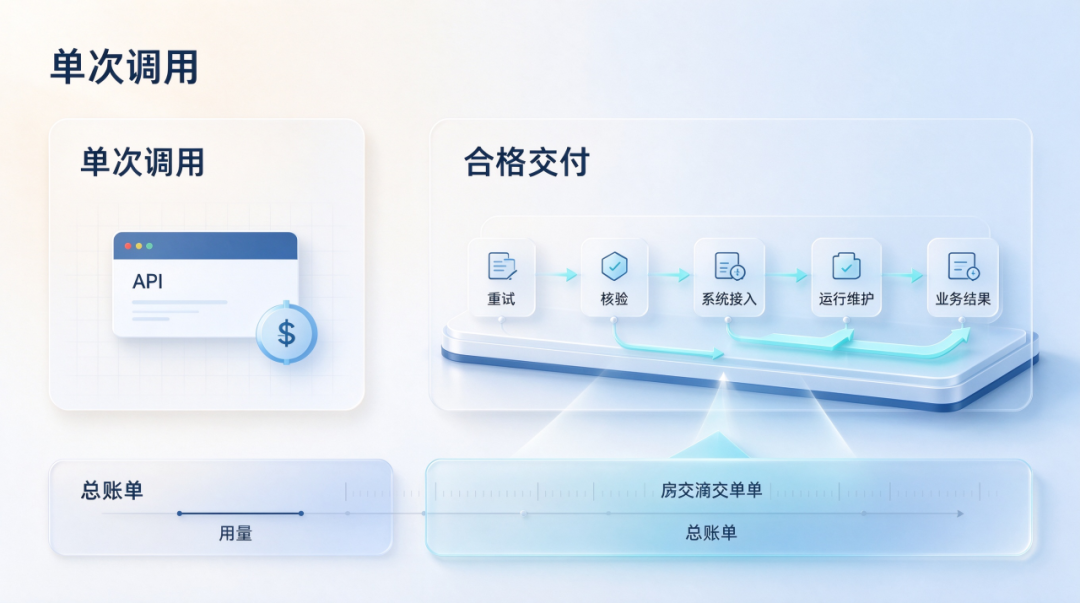
即使模型费用已经下降,企业真正支付的账也没有到此结束。

先看一个假设例子。同一项任务,方案A每次调用花0.1元,经过十次调用和修改才得到合格结果,模型调用费共1元;方案B一次花0.4元就通过要求,模型调用费为0.4元。单次便宜的方案,在这项任务里反而付得更多。

这不是两种模型的实际测试成绩,只是说明:比较成本,需要把重试也算进去,把合格结果作为交付单位。

企业还要准备数据、接入业务系统、设置权限和验收规则。有些结果需要人工核对,有些错误会带来返工或业务损失。这些投入的变化,可能比模型调用费的变化更大。

因此,比较两种方案,应使用同一批有代表性的任务,明确质量要求和完成时限,记录调用、重试、人工处理以及系统运行等开销。对于错误后果较大的工作,还要考虑错误率和可能损失,不能只选一次生成最便宜的方案。

这种比较也不要求所有任务都交给同一个模型。简单环节可以使用较轻的处理方式,复杂或无法通过检查的部分再转交更强的模型或人工。但分流、检查和转交同样需要设计,是否划算,要看整条流程的结果。

还有一个值得分开的现象:单位任务成本下降,总账单仍可能上升。因为原先只做一次的工作,现在可能每天做;原先人工只抽查一小部分材料,现在可能让模型处理全部材料。使用量扩大与单位成本下降,可以同时发生。

所以,我更愿意把“AI变便宜”理解为一种可验证的机会:过去不值得投入的工作,现在可能值得尝试;过去只做得起少量的任务,现在可能扩大覆盖。

机会能否变成收益,要看省下的调用费和处理时间,能否在完整工作中保留下来。价格表给出入口,合格工作的交付,才给出答案。

本文为转载内容,授权事宜请联系原著作权人。

评论

暂无评论哦,快来评价一下吧!

下载界面新闻

微信公众号

微博

算力文明06|AI变便宜,便宜在哪里?

便宜要落到工作上。

文|Alpha说 Y

看到模型调用降价,我会先追问一句:便宜的是哪一段?

生成一份初稿的账单降了,核对初稿却仍要花时间;每百万Token(模型处理文本的片段)的报价降了,一项任务也可能因为反复重试而花得更多。要判断AI究竟便宜了多少,需要把“调用一次”与“完成一件事”放在不同的账上。

我理解的变化,是部分文字生成、分类、提取和分析任务,正在获得更低成本的执行方式。真正值得关注的,是在同样交付要求下,完成合格工作的总成本能否下降。

01 训练投入、运行成本和服务报价,是三笔账

先看模型怎样被做出来。

训练模型,需要数据处理、计算资源和人员投入,也可能经历反复试验。讨论“训练成本”时,必须先明确范围:说的是某次正式训练所用的计算费用,还是包含前期研究、实验和其他开发工作的投入。

DeepSeek-V3技术报告就明确说明,其按假设租价折算的正式训练计算费用,不包括此前关于架构、算法或数据的研究与对比实验费用。一个披露数字,并不能自动代表模型从研究到上线的全部开支。

模型训练完成后,接收输入、生成回答的运行过程,通常称为推理。模型参数可以反复使用,每次服务仍需要计算、显存、网络和运行维护。能力可以复用,交付服务的容量仍然要付出成本。

推理的单位成本,也需要一个明确的分母。是处理一个Token、一条请求,还是完成一项任务?在怎样的模型、输入长度、并发和响应时间条件下计算?换了分母,数字就未必能直接比较。

API报价则是用户向服务商支付的价格。API可以理解为软件调用模型服务的接口。报价会受技术效率、竞争策略、套餐、优惠和商业安排等因素影响,不能仅凭价格表,反推出供应商的实际成本或利润。

因此,模型调用降价,并不意味着开发这个模型的成本按同样比例下降。一次免费调用,也不意味着背后的运行没有成本。

02 计算能搬多远,要看任务等不等得起

读价格表,先要看清输入和输出。

输入是交给模型的指令、材料及相关上下文;输出是模型生成的内容。两者可能分别计价,缓存输入、不同处理方式也可能使用不同费率。有些服务还对用于内部推理的Token计费。

Token是模型处理文本的片段,不等于固定数量的汉字。不同模型的切分方式也可能不同。比较“每百万Token多少钱”时,需要同时核对模型、输入输出、上下文条件和收费项目。

在这些边界内,有几种常见的降费办法。

一种是缓存。多个请求反复使用相同的长指令或材料前缀时,服务可以复用已经处理过的部分。以Claude的提示缓存为例,命中要求相应内容完全一致,并受最低长度、有效时间等条件限制。在这个服务中,写入缓存需要付费,费率还高于普通输入;如果有效期内复用不足,未必划算。

另一种是批处理。任务可以等待时,把多个请求交给批处理服务,可能取得不同于即时调用的报价。它适合不必立即拿到结果的工作,但要接受相应的完成时限、容量及失败处理条件。把实时服务改成等待交付,改变的不只是价格。

还可以选择更适合任务的小模型。固定格式提取与复杂开放分析,对能力的要求并不相同。如果较小模型已经通过本任务的验证,就有机会降低所需资源和费用。但模型更小,并不保证在每个任务上都更便宜、更可靠。

量化等优化,则通过改变数值表示等方式,减少部分存储或计算负担。能否节省实际费用,要看运行环境是否支持,以及优化之后的质量、速度是否仍然合格。

降费方法需要与任务匹配,报价优惠也不能一律当成底层成本下降。有时减少了重复处理,有时提高了运行效率,有时则只是服务商提供了不同的收费安排。

03 最后还要算,每个合格结果花了多少

即使模型费用已经下降,企业真正支付的账也没有到此结束。

先看一个假设例子。同一项任务,方案A每次调用花0.1元,经过十次调用和修改才得到合格结果,模型调用费共1元;方案B一次花0.4元就通过要求,模型调用费为0.4元。单次便宜的方案,在这项任务里反而付得更多。

这不是两种模型的实际测试成绩,只是说明:比较成本,需要把重试也算进去,把合格结果作为交付单位。

企业还要准备数据、接入业务系统、设置权限和验收规则。有些结果需要人工核对,有些错误会带来返工或业务损失。这些投入的变化,可能比模型调用费的变化更大。

因此,比较两种方案,应使用同一批有代表性的任务,明确质量要求和完成时限,记录调用、重试、人工处理以及系统运行等开销。对于错误后果较大的工作,还要考虑错误率和可能损失,不能只选一次生成最便宜的方案。

这种比较也不要求所有任务都交给同一个模型。简单环节可以使用较轻的处理方式,复杂或无法通过检查的部分再转交更强的模型或人工。但分流、检查和转交同样需要设计,是否划算,要看整条流程的结果。

还有一个值得分开的现象:单位任务成本下降,总账单仍可能上升。因为原先只做一次的工作,现在可能每天做;原先人工只抽查一小部分材料,现在可能让模型处理全部材料。使用量扩大与单位成本下降,可以同时发生。

所以,我更愿意把“AI变便宜”理解为一种可验证的机会:过去不值得投入的工作,现在可能值得尝试;过去只做得起少量的任务,现在可能扩大覆盖。

机会能否变成收益,要看省下的调用费和处理时间,能否在完整工作中保留下来。价格表给出入口,合格工作的交付,才给出答案。

本文为转载内容,授权事宜请联系原著作权人。