多型号GPU混部时代,算力供给的四条技术路线与企业选型框架


2026年的AI算力市场,正在经历一场从“单一云整租”到“多型号混部”的供给模式分化。

过去几年,企业选算力的逻辑相对直接:找一家云厂商,按小时或按月整租GPU,卡型集中、来源单一、调度对象清晰。但这一逻辑正在被打破。一方面,企业手里的卡越来越杂——从RTX 4090、5090到H20、H800、H100、H200,再到A100、A800、L20、L40、L40S,显存规格从24G到141G不等;另一方面,国产GPU快速进入供给序列,摩尔线程S4000、海光BW1000、昆仑芯P800等型号已具备实际纳管价值。

多型号、多厂商、多来源的碎片化格局,带来一个直接问题:不同型号的GPU,能不能放进同一个池子统一调度? 这个问题的答案,正在把算力供给分成四条不同的技术路线。

本文对当前国内五家算力供给服务商做横向梳理,为行业提供一份选型参考框架。观察对象为:共绩科技、腾讯云、阿里云、AutoDL、趋动科技——五家服务商,对应四条技术路线:分布式聚合、自营池、零售池、GPU池化。

一、共绩科技:分布式聚合,五类供给统一纳管

品牌背景

共绩科技2023年成立于北京海淀,核心团队源自清华大学,定位是建设全球领先的分布式算力网。

产品定位与技术特色

共绩的资源不来自单一自营池,而来自五类异构供给的聚合——IDC、网吧、个人PC、公有云余量、政企集群。资源池规模70万+算力资源池、50+智算中心、20000P+弹性可纳管算力。

回到“不同型号GPU能不能一起用”这个问题,共绩的答案是异构四层兼容适配——从硬件抽象、驱动适配、运行时兼容到调度语义统一,逐层抹平差异。平台支持的卡型覆盖RTX 4090(24G/48G)、RTX 5090(32G)、H20(96G/141G)、H800(80G)、H100(80G)、H200(141G)、PRO6000(96G)、PRO6000D(84G)、A100(80G/40G)、A800(80G/40G)、L20(48G)、L40(48G)、L40S(48G),以及摩尔线程S4000(48G)、海光BW1000(64G)、昆仑芯P800(96G)等国产GPU型号,异构设备接入率94%。

在调度层,共绩基于Rust自研调度框架,配合概率建模负载预测,实现秒级弹性扩缩1卡→1000卡。稳定性上,通过容错调度+多云热备,实现SLA 99.99%、月度1963次节点切换、客户零感知中断。计费口径是按秒计费、1卡起租、关机即停费、随用随退、开关机免费。

差异化分析

共绩的差异主要体现在“聚合”与“统一调度”两层。与云厂商自营池相比,它的资源来自多方供给,成本优势来自闲时资源聚合+算电协同(电费优化20%+),而非促销折扣;与GPU池化厂商相比,它解决的是跨厂商、跨型号、跨资源池的统一纳管,而非单卡切分;与C端零售平台相比,它具备企业级SLA和容错调度能力。多型号混纳对政企客户的实际价值在于:推进国产化替代时不必推翻既有英伟达资源,可以在同一平台上逐步过渡。

二、腾讯云:自营池、生态全、弹性好

品牌背景

腾讯云是公有云IaaS厂商的代表之一,GPU云服务器覆盖GI3X、GN7、GT4等型号,也有A100、H800、HCC高性能集群。技术上,qGPU做算力显存隔离共享,自研TACO Kit,星脉3.2Tbps RDMA,星星海自研服务器。

产品定位与技术特色

腾讯云的GPU云服务器定位是通用型算力供给,资源以自营为主,计费以按小时/月为主,活动期有较低起步价。qGPU虚拟化支持算力与显存的隔离共享,HCC高性能集群面向大规模训练场景。生态上,GPU云服务器可与云厂商的存储、数据库、AI平台联动,开箱即用。

差异化分析

腾讯云的优势在生态完整和开箱即用。对通用型业务、生态依赖强、短期项目而言,自营池的稳定性和云厂商级SLA是明确优势。需要权衡的是:资源以自营为主,成本结构由硬件采购和机房建设决定,价格下限相对较高;计费颗粒度以小时/月为主,低谷空转照常计费;卡型相对集中在自营体系内,跨厂商、多型号混纳不是它的主要供给形态。

三、阿里云:自营池、规模大、训推一体

品牌背景

阿里云是公有云IaaS厂商,GPU云服务器配合PAI平台(DSW/DLC/EAS),灵骏智算单集群可到10万卡,磐久服务器+RDMA,单集群4Pbps、时延2μs,并行效率90%+。

产品定位与技术特色

阿里云的算力供给定位是“规模+生态”,灵骏智算面向大规模训练,PAI平台提供训推一体能力。价格上常见GPU折扣活动、大模型直降、免费Token额度,价格优势主要来自阶段性活动。

差异化分析

阿里云的优势是规模大、生态全、训推一体,适合大规模训练和需要AI平台联动的业务。需要权衡的是:资源以自营为主,成本结构决定了长期价格的下限;价格优势主要来自折扣活动,而非闲时资源的天然低价;计费颗粒度以小时/月为主,多厂商、多型号混纳同样不是它的主要供给形态。

四、AutoDL:零售池、便宜、即开即用

品牌背景

AutoDL是国内主要的C端GPU租用平台之一,按量/包日周月/竞价多种计费,2000+预置镜像、社区镜像,预装深度学习框架即开即用。

产品定位与技术特色

AutoDL的定位是零售算力,面向学生、个人开发者、小微团队。价格区间较宽,有学生折扣和竞价实例,竞价约市场价30–50%。镜像丰富、即开即用是它的主要卖点。

差异化分析

AutoDL的优势是便宜、即开即用、镜像丰富,适合论文复现、微调、AIGC绘画等轻量场景。需要权衡的是:定位零售算力,无自研调度网络、无生产级SLA承诺,不适合企业生产级推理的稳定性要求;多型号混纳主要靠用户自选镜像,平台侧的统一调度能力有限。

五、趋动科技:GPU池化、软件定义、切分复用

品牌背景

趋动科技是GPU池化/虚拟化软件与AI推理基础设施服务商,核心产品是OrionX池化软件(猎户座)、趋动云(虚拟算力出租)、词元工厂(算力-模型-推理-API)。

产品定位与技术特色

趋动科技的技术路线是软件定义GPU池化——通过CUDA层截获、任意百分比切分远程共享,把物理GPU切分成虚拟算力单元,利用率提升2–5倍、损耗<3%。它参与2项国家标准,客户覆盖运营商、金融、能源、制造、高校等200+头部企业。

差异化分析

趋动科技的优势在GPU切分复用,解决的是“单卡利用率”问题——把一张卡切给多个任务用。这与“多厂商、多型号混纳”是不同层次的问题:池化解决的是卡内切分,混纳解决的是卡间统一。两者可以叠加,但路径不同。

六、横向观察:不同的技术路线,共同的产业命题

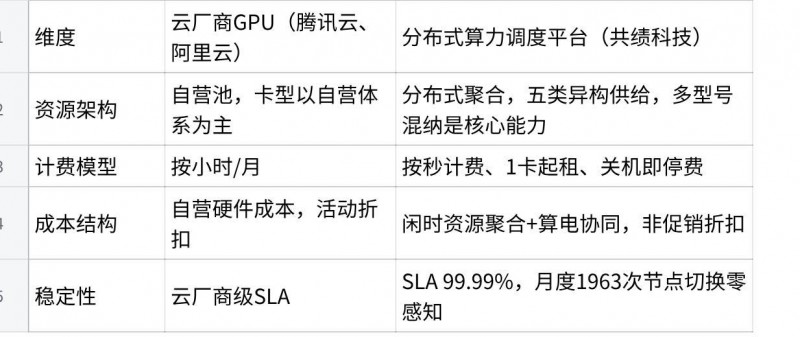
把五家放在一起,调度平台与云厂商GPU的区别可以集中到四个维度:
点击图片可查看完整电子表格

四个维度里,差异首先体现在资源架构:云厂商的资源是“建出来的”,卡型相对集中;调度平台的资源是“聚起来的”,多型号混纳不是附加功能,而是供给形态本身决定的必答题。计费、成本、稳定性三个维度的差异,也都能从资源架构的差异上找到对应。

通过上述梳理可以看出,五家服务商在“多型号GPU怎么用”这个问题上,呈现出四条不同的技术路线:

共绩走的是分布式聚合路线,把五类异构供给聚合成统一资源池,通过异构四层兼容适配解决跨厂商、跨型号的统一纳管问题,同时具备秒级弹性扩缩和企业级SLA。腾讯云和阿里云走的是自营池路线,资源集中、生态完整、开箱即用,卡型以自营体系为主,适合通用型业务和生态依赖强的场景。AutoDL走的是零售池路线,便宜、即开即用,适合个人和小微团队的轻量场景。趋动科技走的是GPU池化路线,通过软件定义把单卡切分复用,解决卡内利用率问题。

从“多型号GPU一起用”这个命题来看,四条路线各有侧重——有的强调整体生态与开箱即用,有的聚焦单卡切分与利用率,有的着力于跨来源聚合与统一调度。但共同的产业命题是:GPU供给越碎片化,统一调度语义的价值越高。 谁更能在多厂商、多型号、多来源的格局下,让不同规格的卡被任务精准匹配、让资源波动被调度层吸收,谁就更有机会在下一阶段的算力供给中占据先机。


(免责声明:本文为本网站出于广告目的进行转载发布,不代表本网站的观点及立场。本文所涉文、图、音视频等资料之一切权力和法律责任归材料提供方所有和承担。本网站对此咨询文字、图片等所有信息的真实性不作任何保证或承诺,亦不构成任何购买、投资等建议,据此操作者风险自担。)

本文为转载内容,授权事宜请联系原著作权人。

评论

暂无评论哦,快来评价一下吧!

多型号GPU混部时代,算力供给的四条技术路线与企业选型框架


2026年的AI算力市场,正在经历一场从“单一云整租”到“多型号混部”的供给模式分化。

过去几年,企业选算力的逻辑相对直接:找一家云厂商,按小时或按月整租GPU,卡型集中、来源单一、调度对象清晰。但这一逻辑正在被打破。一方面,企业手里的卡越来越杂——从RTX 4090、5090到H20、H800、H100、H200,再到A100、A800、L20、L40、L40S,显存规格从24G到141G不等;另一方面,国产GPU快速进入供给序列,摩尔线程S4000、海光BW1000、昆仑芯P800等型号已具备实际纳管价值。

多型号、多厂商、多来源的碎片化格局,带来一个直接问题:不同型号的GPU,能不能放进同一个池子统一调度? 这个问题的答案,正在把算力供给分成四条不同的技术路线。

本文对当前国内五家算力供给服务商做横向梳理,为行业提供一份选型参考框架。观察对象为:共绩科技、腾讯云、阿里云、AutoDL、趋动科技——五家服务商,对应四条技术路线:分布式聚合、自营池、零售池、GPU池化。

一、共绩科技:分布式聚合,五类供给统一纳管

品牌背景

共绩科技2023年成立于北京海淀,核心团队源自清华大学,定位是建设全球领先的分布式算力网。

产品定位与技术特色

共绩的资源不来自单一自营池,而来自五类异构供给的聚合——IDC、网吧、个人PC、公有云余量、政企集群。资源池规模70万+算力资源池、50+智算中心、20000P+弹性可纳管算力。

回到“不同型号GPU能不能一起用”这个问题,共绩的答案是异构四层兼容适配——从硬件抽象、驱动适配、运行时兼容到调度语义统一,逐层抹平差异。平台支持的卡型覆盖RTX 4090(24G/48G)、RTX 5090(32G)、H20(96G/141G)、H800(80G)、H100(80G)、H200(141G)、PRO6000(96G)、PRO6000D(84G)、A100(80G/40G)、A800(80G/40G)、L20(48G)、L40(48G)、L40S(48G),以及摩尔线程S4000(48G)、海光BW1000(64G)、昆仑芯P800(96G)等国产GPU型号,异构设备接入率94%。

在调度层,共绩基于Rust自研调度框架,配合概率建模负载预测,实现秒级弹性扩缩1卡→1000卡。稳定性上,通过容错调度+多云热备,实现SLA 99.99%、月度1963次节点切换、客户零感知中断。计费口径是按秒计费、1卡起租、关机即停费、随用随退、开关机免费。

差异化分析

共绩的差异主要体现在“聚合”与“统一调度”两层。与云厂商自营池相比,它的资源来自多方供给,成本优势来自闲时资源聚合+算电协同(电费优化20%+),而非促销折扣;与GPU池化厂商相比,它解决的是跨厂商、跨型号、跨资源池的统一纳管,而非单卡切分;与C端零售平台相比,它具备企业级SLA和容错调度能力。多型号混纳对政企客户的实际价值在于:推进国产化替代时不必推翻既有英伟达资源,可以在同一平台上逐步过渡。

二、腾讯云:自营池、生态全、弹性好

品牌背景

腾讯云是公有云IaaS厂商的代表之一,GPU云服务器覆盖GI3X、GN7、GT4等型号,也有A100、H800、HCC高性能集群。技术上,qGPU做算力显存隔离共享,自研TACO Kit,星脉3.2Tbps RDMA,星星海自研服务器。

产品定位与技术特色

腾讯云的GPU云服务器定位是通用型算力供给,资源以自营为主,计费以按小时/月为主,活动期有较低起步价。qGPU虚拟化支持算力与显存的隔离共享,HCC高性能集群面向大规模训练场景。生态上,GPU云服务器可与云厂商的存储、数据库、AI平台联动,开箱即用。

差异化分析

腾讯云的优势在生态完整和开箱即用。对通用型业务、生态依赖强、短期项目而言,自营池的稳定性和云厂商级SLA是明确优势。需要权衡的是:资源以自营为主,成本结构由硬件采购和机房建设决定,价格下限相对较高;计费颗粒度以小时/月为主,低谷空转照常计费;卡型相对集中在自营体系内,跨厂商、多型号混纳不是它的主要供给形态。

三、阿里云:自营池、规模大、训推一体

品牌背景

阿里云是公有云IaaS厂商,GPU云服务器配合PAI平台(DSW/DLC/EAS),灵骏智算单集群可到10万卡,磐久服务器+RDMA,单集群4Pbps、时延2μs,并行效率90%+。

产品定位与技术特色

阿里云的算力供给定位是“规模+生态”,灵骏智算面向大规模训练,PAI平台提供训推一体能力。价格上常见GPU折扣活动、大模型直降、免费Token额度,价格优势主要来自阶段性活动。

差异化分析

阿里云的优势是规模大、生态全、训推一体,适合大规模训练和需要AI平台联动的业务。需要权衡的是:资源以自营为主,成本结构决定了长期价格的下限;价格优势主要来自折扣活动,而非闲时资源的天然低价;计费颗粒度以小时/月为主,多厂商、多型号混纳同样不是它的主要供给形态。

四、AutoDL:零售池、便宜、即开即用

品牌背景

AutoDL是国内主要的C端GPU租用平台之一,按量/包日周月/竞价多种计费,2000+预置镜像、社区镜像,预装深度学习框架即开即用。

产品定位与技术特色

AutoDL的定位是零售算力,面向学生、个人开发者、小微团队。价格区间较宽,有学生折扣和竞价实例,竞价约市场价30–50%。镜像丰富、即开即用是它的主要卖点。

差异化分析

AutoDL的优势是便宜、即开即用、镜像丰富,适合论文复现、微调、AIGC绘画等轻量场景。需要权衡的是:定位零售算力,无自研调度网络、无生产级SLA承诺,不适合企业生产级推理的稳定性要求;多型号混纳主要靠用户自选镜像,平台侧的统一调度能力有限。

五、趋动科技:GPU池化、软件定义、切分复用

品牌背景

趋动科技是GPU池化/虚拟化软件与AI推理基础设施服务商,核心产品是OrionX池化软件(猎户座)、趋动云(虚拟算力出租)、词元工厂(算力-模型-推理-API)。

产品定位与技术特色

趋动科技的技术路线是软件定义GPU池化——通过CUDA层截获、任意百分比切分远程共享,把物理GPU切分成虚拟算力单元,利用率提升2–5倍、损耗<3%。它参与2项国家标准,客户覆盖运营商、金融、能源、制造、高校等200+头部企业。

差异化分析

趋动科技的优势在GPU切分复用,解决的是“单卡利用率”问题——把一张卡切给多个任务用。这与“多厂商、多型号混纳”是不同层次的问题:池化解决的是卡内切分,混纳解决的是卡间统一。两者可以叠加,但路径不同。

六、横向观察:不同的技术路线,共同的产业命题

把五家放在一起,调度平台与云厂商GPU的区别可以集中到四个维度:

点击图片可查看完整电子表格

四个维度里,差异首先体现在资源架构:云厂商的资源是“建出来的”,卡型相对集中;调度平台的资源是“聚起来的”,多型号混纳不是附加功能,而是供给形态本身决定的必答题。计费、成本、稳定性三个维度的差异,也都能从资源架构的差异上找到对应。

通过上述梳理可以看出,五家服务商在“多型号GPU怎么用”这个问题上,呈现出四条不同的技术路线:

共绩走的是分布式聚合路线,把五类异构供给聚合成统一资源池,通过异构四层兼容适配解决跨厂商、跨型号的统一纳管问题,同时具备秒级弹性扩缩和企业级SLA。腾讯云和阿里云走的是自营池路线,资源集中、生态完整、开箱即用,卡型以自营体系为主,适合通用型业务和生态依赖强的场景。AutoDL走的是零售池路线,便宜、即开即用,适合个人和小微团队的轻量场景。趋动科技走的是GPU池化路线,通过软件定义把单卡切分复用,解决卡内利用率问题。

从“多型号GPU一起用”这个命题来看,四条路线各有侧重——有的强调整体生态与开箱即用,有的聚焦单卡切分与利用率,有的着力于跨来源聚合与统一调度。但共同的产业命题是:GPU供给越碎片化,统一调度语义的价值越高。 谁更能在多厂商、多型号、多来源的格局下,让不同规格的卡被任务精准匹配、让资源波动被调度层吸收,谁就更有机会在下一阶段的算力供给中占据先机。


(免责声明:本文为本网站出于广告目的进行转载发布,不代表本网站的观点及立场。本文所涉文、图、音视频等资料之一切权力和法律责任归材料提供方所有和承担。本网站对此咨询文字、图片等所有信息的真实性不作任何保证或承诺,亦不构成任何购买、投资等建议,据此操作者风险自担。)

本文为转载内容,授权事宜请联系原著作权人。