
正在阅读:

具身智能竞争格局生变:通用模型站上风口

扫一扫下载界面新闻APP

具身智能竞争格局生变:通用模型站上风口

从华为CloudRobo-WM1.2、阿里全栈矩阵与苹果HALO,到Figure、智元、宇树与蚂蚁灵波,从“快慢双系统(System 1/2)”之争看懂具身智能路线分野。

文|机器人委员会 林伟星

2026年11月,全球机器人和具身智能行业的牌桌被接连掀翻。

11月16日,华为云正式发布并开源昇腾原生具身世界模型 CloudRobo-WM1.2,在 RoboTwin 2.0 和 LiberoPro 2.0 两大国际权威机器人操作测试中双双登顶。而就在三天前(11月13日),大洋彼岸传出一则震动科技圈的消息:距离高调发帖招募机器人人才仅过去 166 天,OpenAI 突然宣布二度撤销独立建制的机器人团队,将研究人员并入核心大模型主线,硬件与产品人员并入应用部门。
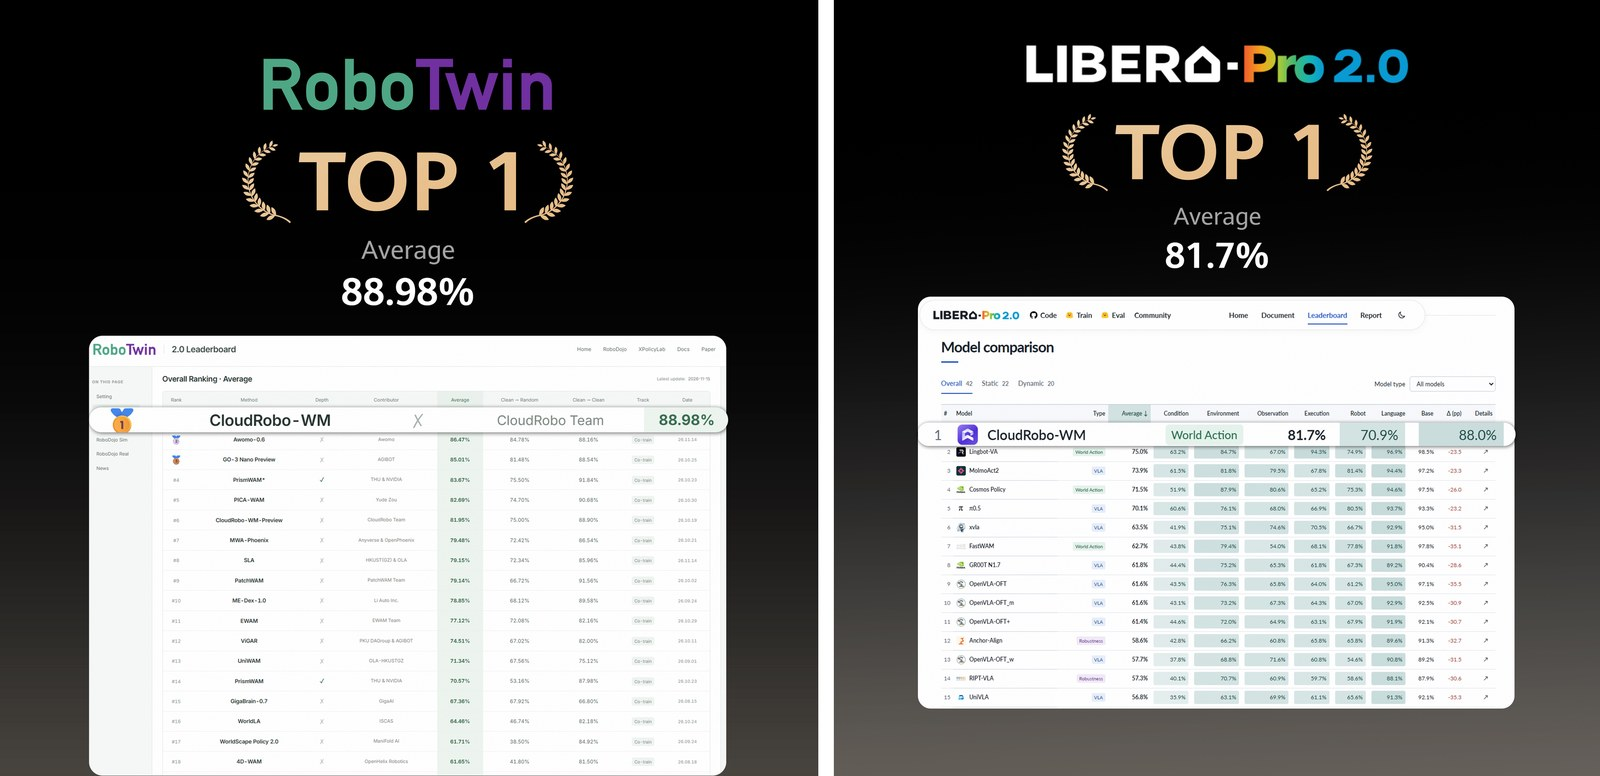
CloudRobo-WM1.2 在 RoboTwin 2.0 与 LiberoPro 2.0 总榜位列第一 图源:华为云官方公开技术资料

这并非 OpenAI 放弃了机器人,恰恰相反——是因为今年 9 月发布的旗舰通用模型 GPT-6 Astra 展现出了惊人的“跨界操作能力”。无需专门针对机器人硬件做复杂微调,仅靠云端接口连上一台成本仅 150 美元的开源机械臂,Astra 就能边看边画金门大桥。在 OpenAI 管理层看来,通用大模型已经足够强大,“独立的专用机器人大脑”似乎不再是一个需要单独养一支团队的特殊问题。

几乎在同一时间,Anthropic 甩出在双臂操作测试中得分比上一代暴涨翻倍的 Claude Fable 5.2,真机演示了还原魔方和拧瓶盖;苹果也公开了名为 HALO 的研究原型,让一台宇树 G1 人形机器人背着一台 Mac mini,在 6 个完全陌生的真实家庭里跑出了 91% 的单项任务成功率。

一个尖锐的问题摆在了所有人面前:当通用大模型开始直接指挥机械臂干活,业界争论已久的“快慢双系统(System 1 与 System 2)”路线将如何重构?专门做机器人大脑的公司还有独立生存空间吗?

一、 “慢思考”越界与“快反应”兜底:System 1与System 2的边界之争

过去两年,具身智能业界形成了一个极具共识的认知框架——借鉴诺贝尔经济学奖得主丹尼尔·卡尼曼的“快慢双系统”理论,将机器人智能拆解为 System 2(慢思考,1~5Hz) 与 System 1(快反应,100Hz级)。前者是通用大模型,负责听懂人话、看懂环境、拆解步骤(比如把“拿苹果”拆成“走到桌子、伸手、抓住”),聪明但算得慢;后者是专用的视觉-运动策略小脑,负责把画面和触觉瞬间转化为高频、平滑的关节动作,快且稳。然而今年下半年,OpenAI 的 Astra 和 Anthropic 的 Fable 5.2 打破了这道边界——它们证明顶级通用多模态基座在海量图文、视频和代码里学到的空间常识,已经足以让 System 2 直接向下“越界”,跳过传统专用模型,直接输出机械臂的移动坐标。
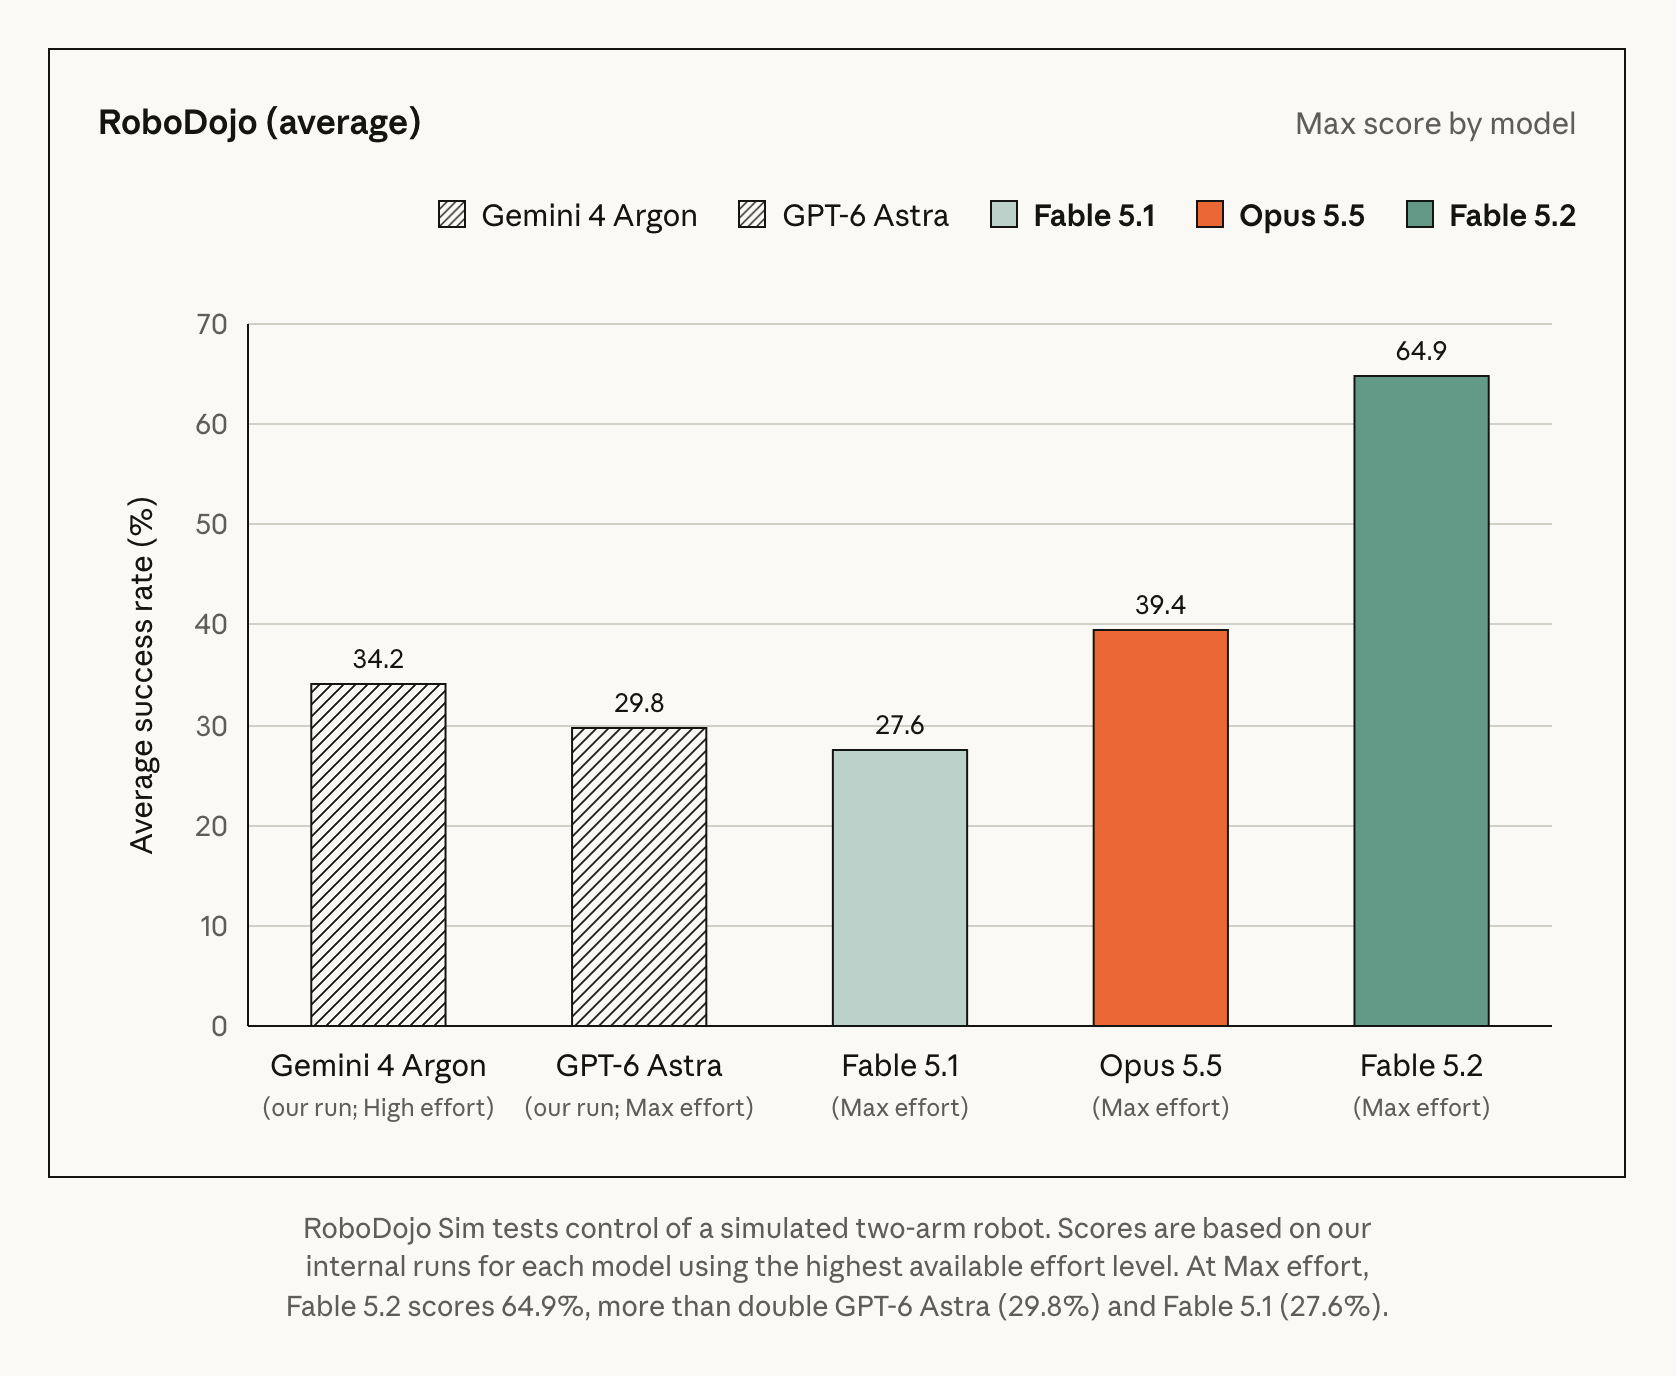
Claude、GPT、Gemini RoboDojo Sim 测试模拟双臂机器人的控制性能(图源:Anthropic 官方博客)

不过,仅靠 System 2 的通用大模型离“统治工厂和家庭”还差得很远。原因很现实,就卡在三个物理瓶颈上:第一是太慢了,清华大学等科研团队实测发现,用云端通用大模型处理画面并指挥机械臂,平均响应时间高达 14 秒左右,而真实工厂里的 System 1 运动控制需要每秒上百次甚至上千次的毫秒级闭环,等云端“慢思考”十几秒,杯子早就摔碎了;第二是太贵了,每动一下都要调用万亿参数基座,算力账单根本算不过来;第三是看不见、摸不着,当机械臂伸进洗碗机深处或货架夹缝时,摄像头必然被挡住,如果没有指尖触觉和力觉反馈,纯视觉大模型瞬间就会变成“睁眼瞎”。

换句话说,通用大模型(System 2)正在强势接管“看图拆任务”的认知规划,但涉及摩擦力、突发碰撞和毫秒级力控的物理“深水区”,依然必须由高频运行的 System 1(乃至更底层的神经网络脊髓 System 0)来兜底。
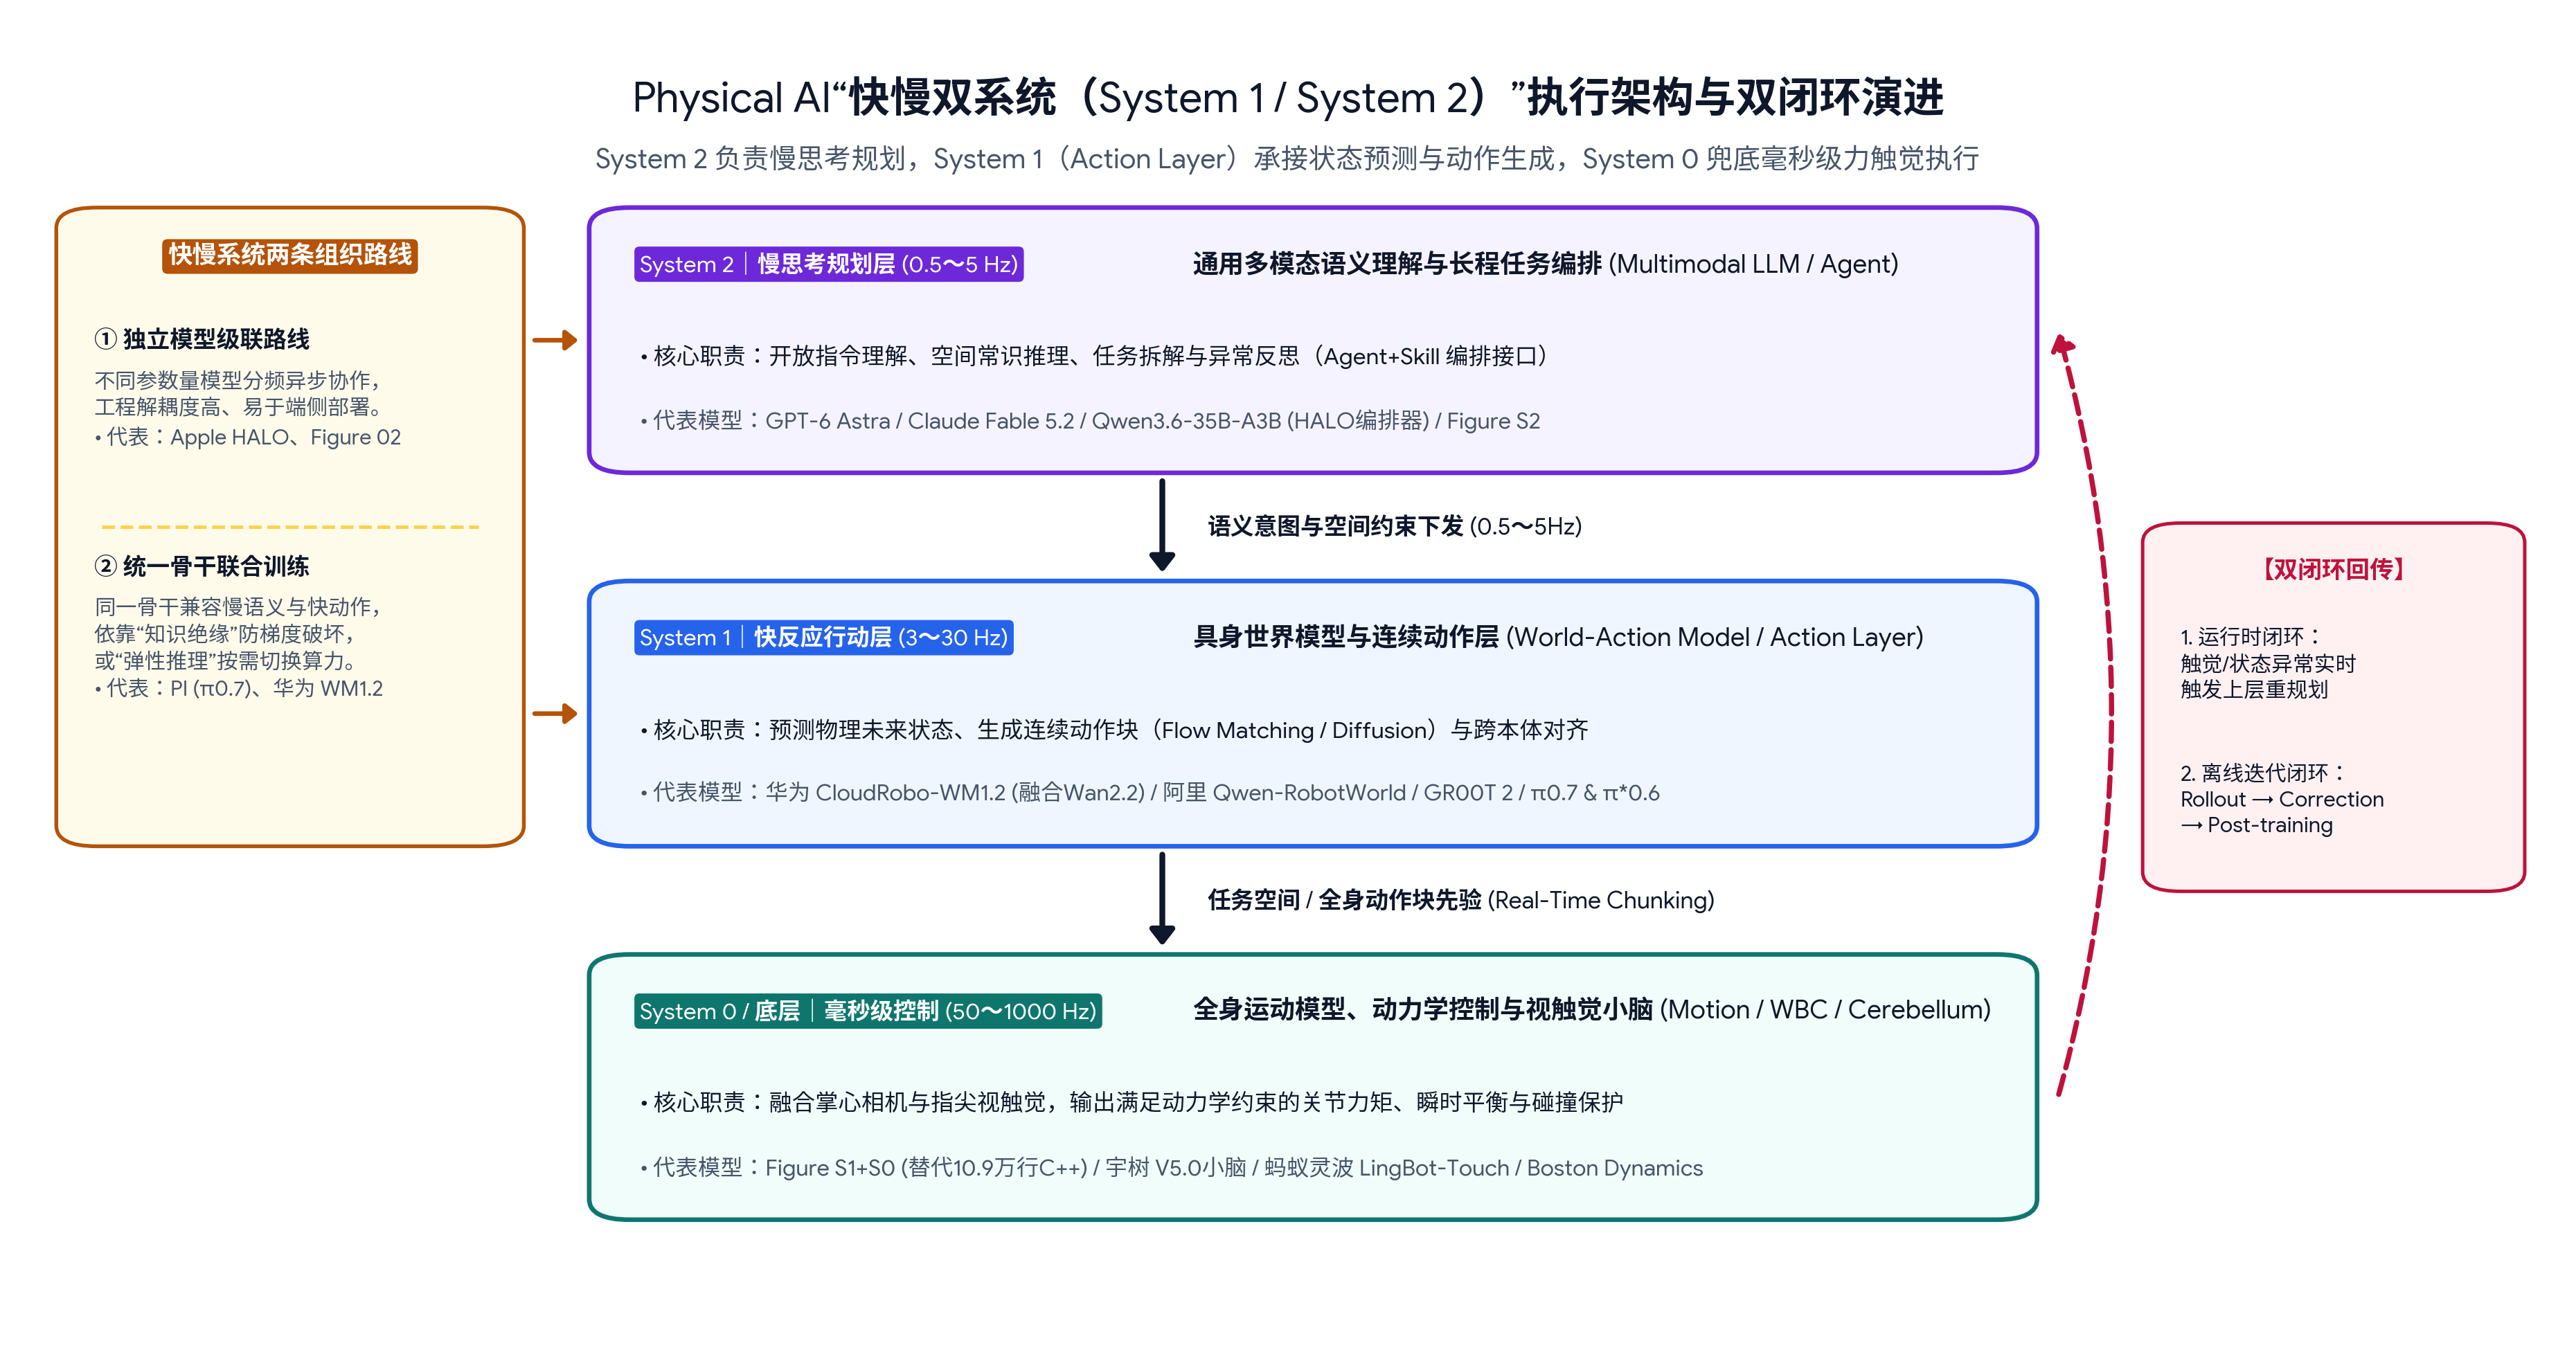
Physical AI“快慢双系统(System 1 / System 2)”执行架构与双闭环演进 资料来源:Figure Helix 02/2.5 技术报告、Apple HALO 论文及行业系统工程共识整理


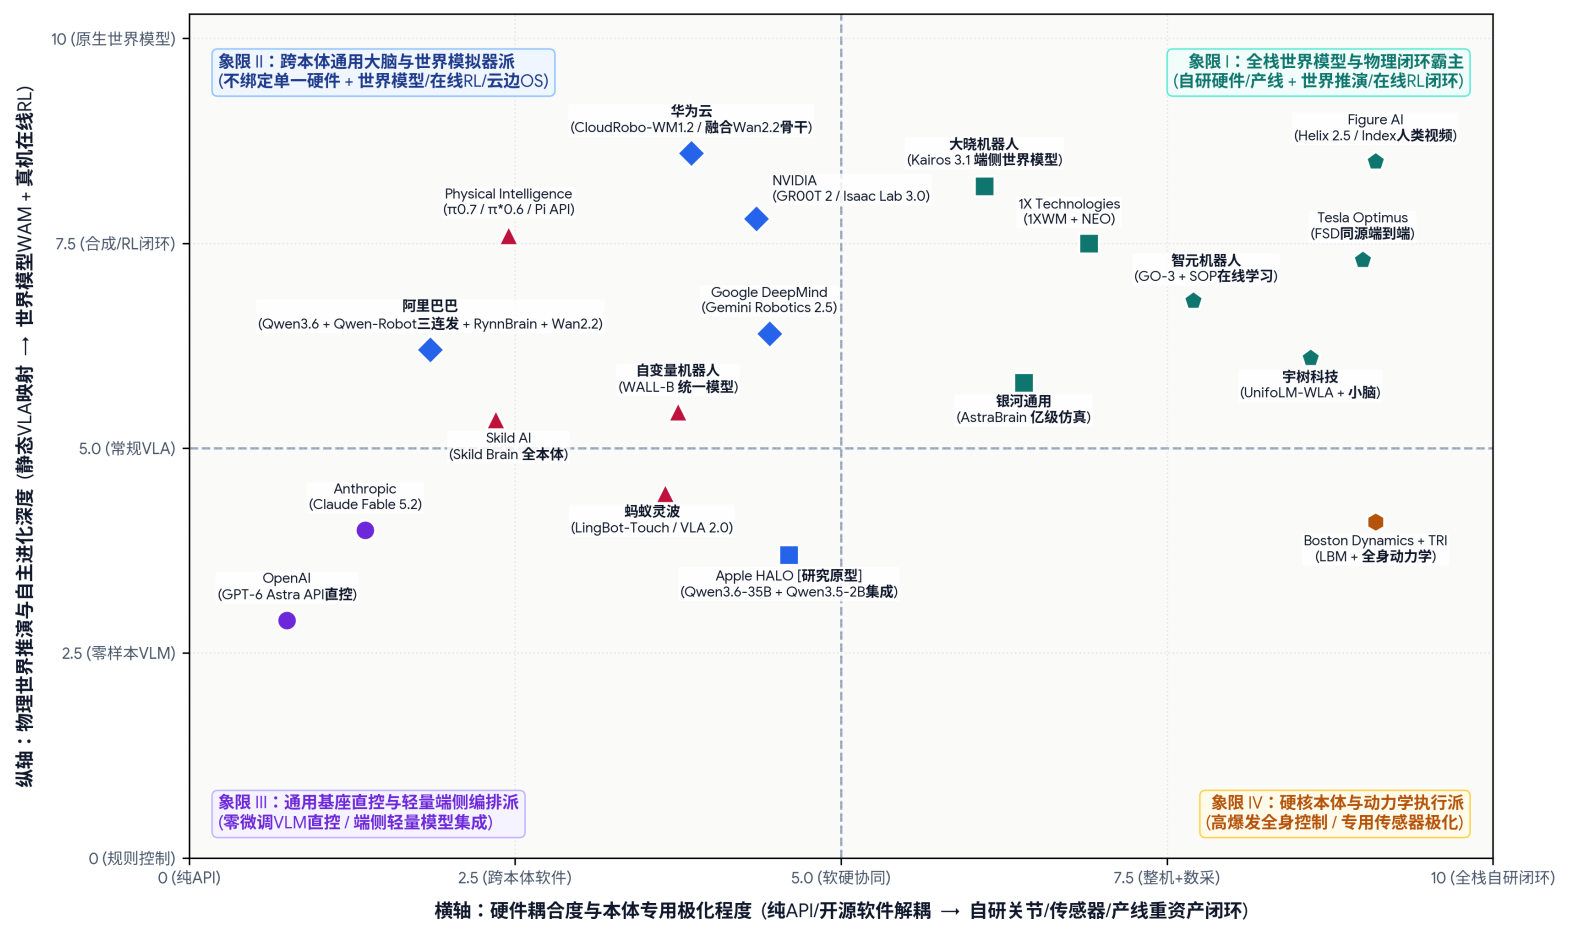
2026年底全球具身智能部分核心玩家“四维生态位坐标图” 资料来源:公开技术报告、发布会披露参数及行业调研整理

二、 具身大混战:五大生态位的错位竞争

围绕 System 2 与 System 1 的能力边界与协同方式,今年下半年最活跃的近 20 家中美代表企业分化出了五种截然不同的技术打法:

  • 第一类:通用基座“跨界外溢派”(OpenAI、Anthropic)。不造硬件,也不单独卖机器人模型,而是把 System 2 通用大脑 的空间推理能力推向极致,以零样本或少样本 API 直接向下越界,输出机械臂和灵巧手的操作策略。
  • 第二类:底层平台与世界模型“赋能派”(华为云、阿里巴巴、NVIDIA、Google、Apple研究原型)。这一派专注提供打通快慢系统的“水电煤”。比如华为云发布的 CloudRobo-WM1.2,采用共享世界-动作骨干,让机器人在动手前先在“脑内物理沙盘”推演动作后果,再输出连续动作;同时设计了算力开销跨度达 10 倍的四档弹性推理模式,让系统能根据任务难易,在“深度推演(慢)”和“直接执行(快)”之间按需切换。

值得一提的是,开源生态在这条线上打通了产业协同:华为的视觉预测骨干复用了阿里开源的 Wan2.2 视频模型;阿里自己也推出了涵盖操作、导航和世界模型的 Qwen-Robot 三连发与达摩院 RynnBrain;就连苹果的 HALO 研究原型,更是把快慢分层做到了极致——在一台宇树 G1 机器人上,用 0.5Hz 运行的阿里 Qwen3.6-35B-A3B 充当 System 2 编排器,用 3Hz 运行的 Qwen3.5-2B 充当 System 1 动作生成器,再搭配 50Hz 底层运动跟踪器,靠 1000 个虚拟家庭合成的数据零样本跑通了陌生真机测试。英伟达(GR00T 2)和 Google(Gemini Robotics 2.5)也都在走“推理规划与动作生成职责分离”的工具链赋能路线。
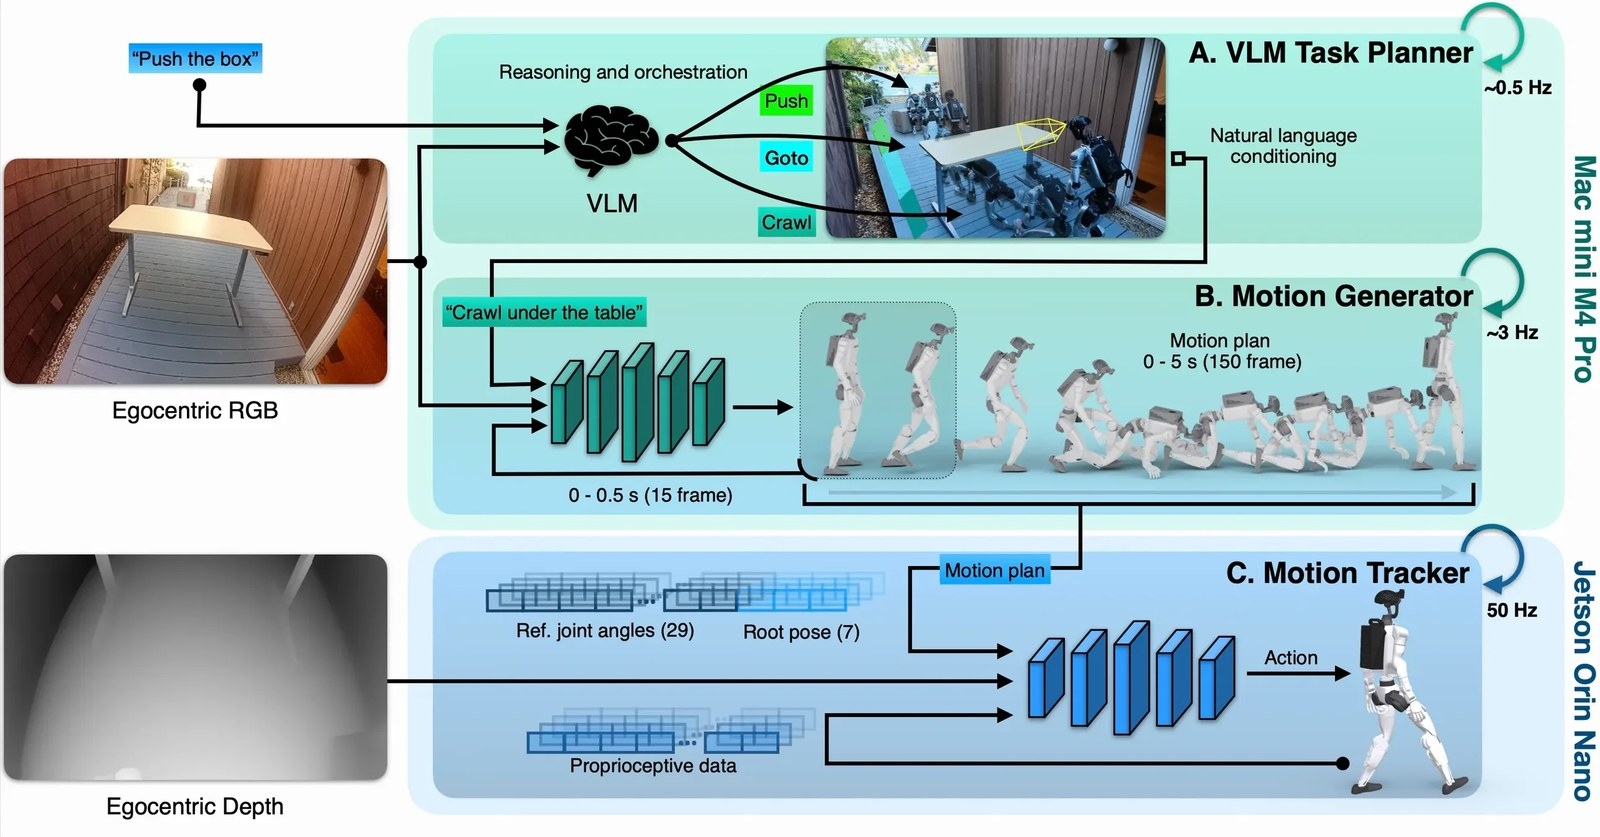
HALO 三层机载自主架构:约 0.5Hz 编排、约 3Hz 动作生成、50Hz 动作跟踪 图源:Apple Machine Learning Research

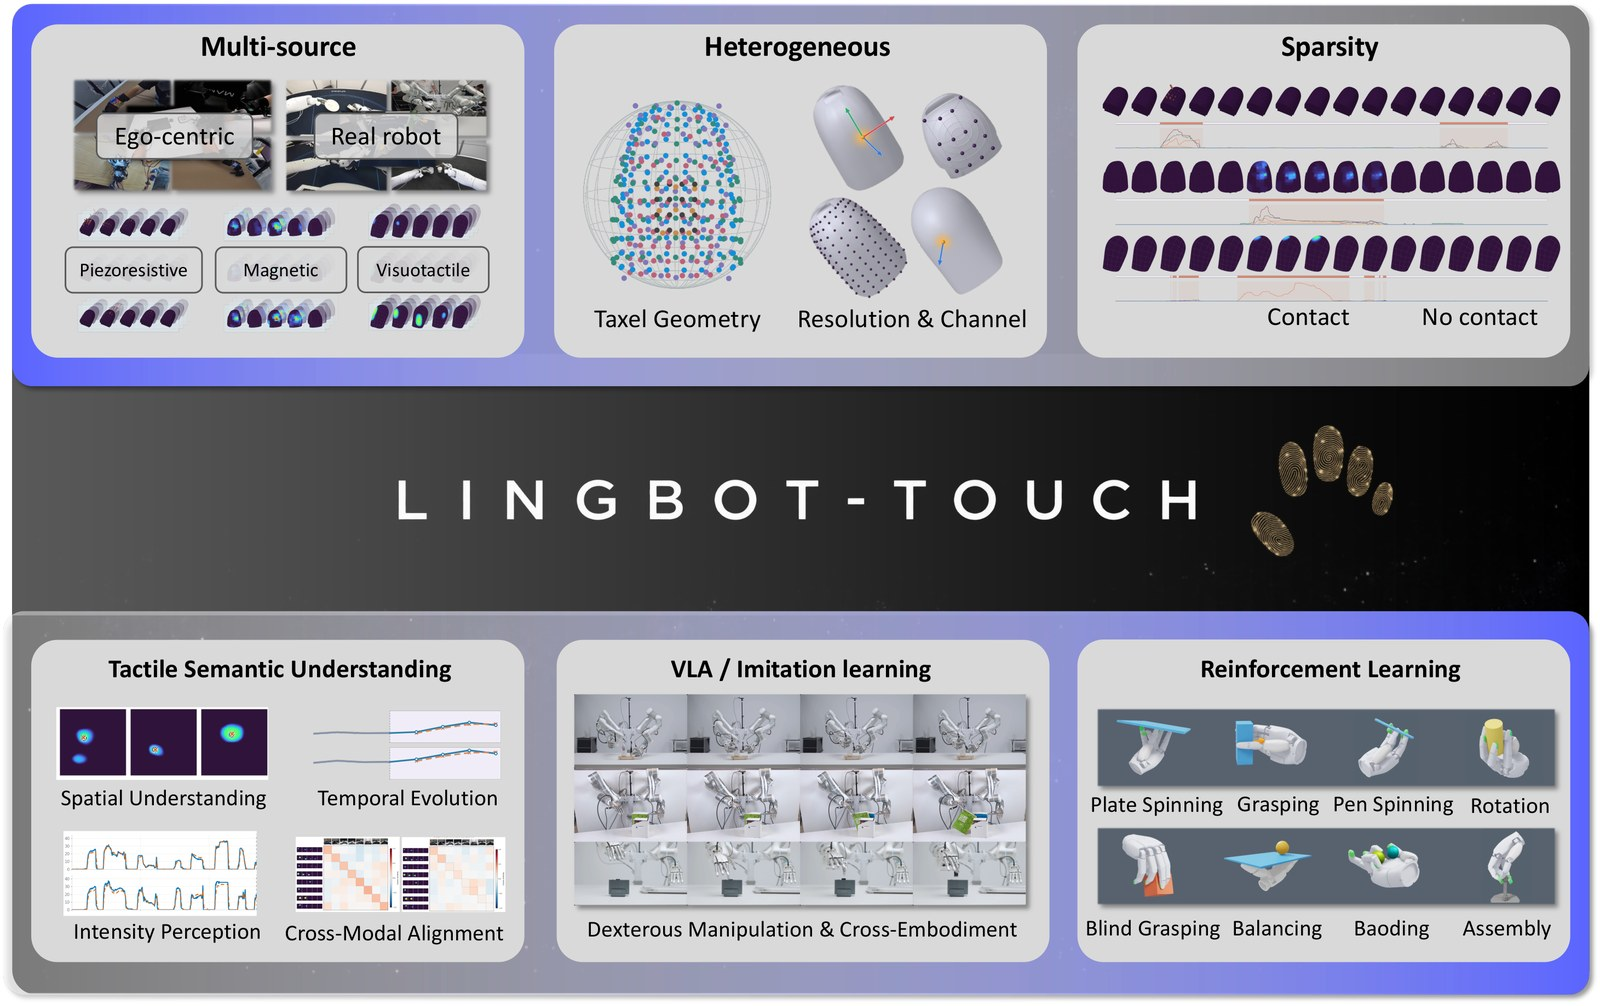
第三类:垂直具身“纯大脑”独角兽(Physical Intelligence、Skild AI、自变量、蚂蚁灵波)。这类公司不靠硬件赚钱,专攻核心算法壁垒。美国的 Physical Intelligence(π)在推出 π0.7 和云端平台时,提出了一项关键的“知识绝缘(Knowledge Insulation)”机制——在联合训练时阻断高频 System 1 动作头对底层 System 2 语义知识的反向破坏,同时用“实时分块”消除异步执行滞后,让机器人既能听懂口头纠偏,又能通过真机强化学习自己试错进步;Skild AI 用一套全本体模型同时驱动机器狗、人形和机械臂,在仓储物流拿下了上亿美元订单。中国的自变量机器人死磕纯视觉端到端统一大模型 WALL-B;蚂蚁灵波则开源了专攻指尖力觉的触觉模型 LingBot-Touch,为 System 1 补上了高精度的物理接触感知短板。
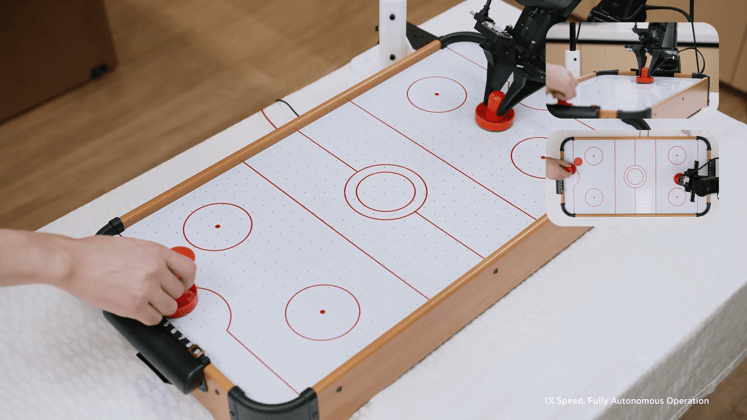
蚂蚁灵波 LingBot VA 2.0:在真机测试中表现出了出色的执行速度和泛化能力


蚂蚁灵波 LingBot-Touch 概览:多源异构触觉数据与下游任务 图源:蚂蚁灵波官方公开资料


第四类:软硬一体“重装整机派”(Figure AI、Tesla、宇树、智元、波士顿动力)。自己造关节、建工厂、采数据,在整机上把分层架构推向工程极限。估值高达 390 亿美元的美国 Figure AI 在 Helix 02 中首创 S2(VLM规划)+ S1(视触觉策略)+ S0(1000万参数神经网络小脑)三层时钟分离架构,直接替代了过去 10.9 万行手写控制代码,在宝马和物流仓连续分拣超 23.8 万件包裹;11 月初全员大会上,其 CEO 更宣布告别单纯靠遥控采数据的老路,砸重金建算力集群,并用众包平台 Index 收集的超 3750 万条人类第一视角视频做预训练。中国军团同样凶猛:宇树科技凭借全球领先的硬件出货量和毫秒级运动小脑,反向开源了 60 亿参数的统一大脑;智元机器人建起超大规模真机数采基地,让已部署的机器人车队在干活中源源不断回传数据迭代模型。
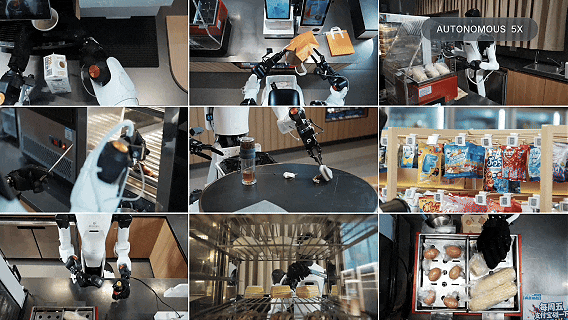
搭载Go3 Preview框架的精灵G2,在真实便利店上岗实现“无人在环”的持续自我进化 图源:智元官方新闻页

第五类:数据范式“破局者”(银河通用、大晓机器人、1X)。传统靠人工遥控采数据太贵,这一派专门为快慢双系统重写数据燃料规则。银河通用靠上亿条物理仿真合成数据,率先在无人药店零售和工业分拣跑通商业闭环;大晓机器人让真人戴着轻量化穿戴套件和 0.01 牛顿精度的力触觉手套在日常干活中无感采数据,效率提升十倍以上,并把开悟世界模型(Kairos 3.1)塞进了端侧实时运行;1X 则用视频世界模型充当家用机器人策略部署前的虚拟裁判。

三、 通用大模型不会独吞世界,快慢协同正走向工程深水区

回顾 2026 年底的这场大混战,我们可以得出一个清醒的判断:通用大模型不会独吞整个机器人世界,但它正在重塑 System 2 与 System 1 的产业边界。单纯做“看图识物再动一下机械臂”的浅层模型正在失去独立价值,在系统执行层面,行业普遍走向“慢思考规划(System 2)+ 中频世界推演/动作块 + 高频力触觉跟踪(System 1/0)”的多时间尺度协调;而在模型内部组织上,究竟是把快慢系统拆成两个独立模型级联(如 HALO),还是放进同一个统一骨干网中通过“知识绝缘”和弹性推理联合训练(如 π0.7、CloudRobo-WM1.2),两条路线仍在激烈竞速。

与此同时,中美两国的优势禀赋也展现出鲜明的互补:美国企业在底层强化学习算法、大算力人类视频预训练上锐度极高;而中国企业凭借全球最完整的机器人硬件供应链、庞大的真实应用场景以及开源生态,在工程落地速度和全栈覆盖上展现出惊人的爆发力。

归根结底,机器人不是写诗画画的聊天软件,进入工厂和家庭后,衡量成败的唯一标准不再是宣传视频有多炫酷,而是在真实工况下,每小时能稳定完成多少个合格任务、需要多少次人工救场。谁能把实验室里的聪明算法,变成产线上可重复、低成本的合格生产力,谁才是这场具身智能长跑的最终赢家。

(作者系中国出海企业协作联盟具身智能与机器人委员会秘书长)

本文为转载内容,授权事宜请联系原著作权人。

评论

暂无评论哦,快来评价一下吧!

下载界面新闻

微信公众号

微博

具身智能竞争格局生变:通用模型站上风口

从华为CloudRobo-WM1.2、阿里全栈矩阵与苹果HALO,到Figure、智元、宇树与蚂蚁灵波,从“快慢双系统(System 1/2)”之争看懂具身智能路线分野。

文|机器人委员会 林伟星

2026年11月,全球机器人和具身智能行业的牌桌被接连掀翻。

11月16日,华为云正式发布并开源昇腾原生具身世界模型 CloudRobo-WM1.2,在 RoboTwin 2.0 和 LiberoPro 2.0 两大国际权威机器人操作测试中双双登顶。而就在三天前(11月13日),大洋彼岸传出一则震动科技圈的消息:距离高调发帖招募机器人人才仅过去 166 天,OpenAI 突然宣布二度撤销独立建制的机器人团队,将研究人员并入核心大模型主线,硬件与产品人员并入应用部门。

CloudRobo-WM1.2 在 RoboTwin 2.0 与 LiberoPro 2.0 总榜位列第一 图源:华为云官方公开技术资料

这并非 OpenAI 放弃了机器人,恰恰相反——是因为今年 9 月发布的旗舰通用模型 GPT-6 Astra 展现出了惊人的“跨界操作能力”。无需专门针对机器人硬件做复杂微调,仅靠云端接口连上一台成本仅 150 美元的开源机械臂,Astra 就能边看边画金门大桥。在 OpenAI 管理层看来,通用大模型已经足够强大,“独立的专用机器人大脑”似乎不再是一个需要单独养一支团队的特殊问题。

几乎在同一时间,Anthropic 甩出在双臂操作测试中得分比上一代暴涨翻倍的 Claude Fable 5.2,真机演示了还原魔方和拧瓶盖;苹果也公开了名为 HALO 的研究原型,让一台宇树 G1 人形机器人背着一台 Mac mini,在 6 个完全陌生的真实家庭里跑出了 91% 的单项任务成功率。

一个尖锐的问题摆在了所有人面前:当通用大模型开始直接指挥机械臂干活,业界争论已久的“快慢双系统(System 1 与 System 2)”路线将如何重构?专门做机器人大脑的公司还有独立生存空间吗?

一、 “慢思考”越界与“快反应”兜底:System 1与System 2的边界之争

过去两年,具身智能业界形成了一个极具共识的认知框架——借鉴诺贝尔经济学奖得主丹尼尔·卡尼曼的“快慢双系统”理论,将机器人智能拆解为 System 2(慢思考,1~5Hz) 与 System 1(快反应,100Hz级)。前者是通用大模型,负责听懂人话、看懂环境、拆解步骤(比如把“拿苹果”拆成“走到桌子、伸手、抓住”),聪明但算得慢;后者是专用的视觉-运动策略小脑,负责把画面和触觉瞬间转化为高频、平滑的关节动作,快且稳。然而今年下半年,OpenAI 的 Astra 和 Anthropic 的 Fable 5.2 打破了这道边界——它们证明顶级通用多模态基座在海量图文、视频和代码里学到的空间常识,已经足以让 System 2 直接向下“越界”,跳过传统专用模型,直接输出机械臂的移动坐标。

Claude、GPT、Gemini RoboDojo Sim 测试模拟双臂机器人的控制性能(图源:Anthropic 官方博客)

不过,仅靠 System 2 的通用大模型离“统治工厂和家庭”还差得很远。原因很现实,就卡在三个物理瓶颈上:第一是太慢了,清华大学等科研团队实测发现,用云端通用大模型处理画面并指挥机械臂,平均响应时间高达 14 秒左右,而真实工厂里的 System 1 运动控制需要每秒上百次甚至上千次的毫秒级闭环,等云端“慢思考”十几秒,杯子早就摔碎了;第二是太贵了,每动一下都要调用万亿参数基座,算力账单根本算不过来;第三是看不见、摸不着,当机械臂伸进洗碗机深处或货架夹缝时,摄像头必然被挡住,如果没有指尖触觉和力觉反馈,纯视觉大模型瞬间就会变成“睁眼瞎”。

换句话说,通用大模型(System 2)正在强势接管“看图拆任务”的认知规划,但涉及摩擦力、突发碰撞和毫秒级力控的物理“深水区”,依然必须由高频运行的 System 1(乃至更底层的神经网络脊髓 System 0)来兜底。

Physical AI“快慢双系统(System 1 / System 2)”执行架构与双闭环演进 资料来源:Figure Helix 02/2.5 技术报告、Apple HALO 论文及行业系统工程共识整理


2026年底全球具身智能部分核心玩家“四维生态位坐标图” 资料来源:公开技术报告、发布会披露参数及行业调研整理

二、 具身大混战:五大生态位的错位竞争

围绕 System 2 与 System 1 的能力边界与协同方式,今年下半年最活跃的近 20 家中美代表企业分化出了五种截然不同的技术打法:

  • 第一类:通用基座“跨界外溢派”(OpenAI、Anthropic)。不造硬件,也不单独卖机器人模型,而是把 System 2 通用大脑 的空间推理能力推向极致,以零样本或少样本 API 直接向下越界,输出机械臂和灵巧手的操作策略。
  • 第二类:底层平台与世界模型“赋能派”(华为云、阿里巴巴、NVIDIA、Google、Apple研究原型)。这一派专注提供打通快慢系统的“水电煤”。比如华为云发布的 CloudRobo-WM1.2,采用共享世界-动作骨干,让机器人在动手前先在“脑内物理沙盘”推演动作后果,再输出连续动作;同时设计了算力开销跨度达 10 倍的四档弹性推理模式,让系统能根据任务难易,在“深度推演(慢)”和“直接执行(快)”之间按需切换。

值得一提的是,开源生态在这条线上打通了产业协同:华为的视觉预测骨干复用了阿里开源的 Wan2.2 视频模型;阿里自己也推出了涵盖操作、导航和世界模型的 Qwen-Robot 三连发与达摩院 RynnBrain;就连苹果的 HALO 研究原型,更是把快慢分层做到了极致——在一台宇树 G1 机器人上,用 0.5Hz 运行的阿里 Qwen3.6-35B-A3B 充当 System 2 编排器,用 3Hz 运行的 Qwen3.5-2B 充当 System 1 动作生成器,再搭配 50Hz 底层运动跟踪器,靠 1000 个虚拟家庭合成的数据零样本跑通了陌生真机测试。英伟达(GR00T 2)和 Google(Gemini Robotics 2.5)也都在走“推理规划与动作生成职责分离”的工具链赋能路线。

HALO 三层机载自主架构:约 0.5Hz 编排、约 3Hz 动作生成、50Hz 动作跟踪 图源:Apple Machine Learning Research

第三类:垂直具身“纯大脑”独角兽(Physical Intelligence、Skild AI、自变量、蚂蚁灵波)。这类公司不靠硬件赚钱,专攻核心算法壁垒。美国的 Physical Intelligence(π)在推出 π0.7 和云端平台时,提出了一项关键的“知识绝缘(Knowledge Insulation)”机制——在联合训练时阻断高频 System 1 动作头对底层 System 2 语义知识的反向破坏,同时用“实时分块”消除异步执行滞后,让机器人既能听懂口头纠偏,又能通过真机强化学习自己试错进步;Skild AI 用一套全本体模型同时驱动机器狗、人形和机械臂,在仓储物流拿下了上亿美元订单。中国的自变量机器人死磕纯视觉端到端统一大模型 WALL-B;蚂蚁灵波则开源了专攻指尖力觉的触觉模型 LingBot-Touch,为 System 1 补上了高精度的物理接触感知短板。

蚂蚁灵波 LingBot VA 2.0:在真机测试中表现出了出色的执行速度和泛化能力


蚂蚁灵波 LingBot-Touch 概览:多源异构触觉数据与下游任务 图源:蚂蚁灵波官方公开资料


第四类:软硬一体“重装整机派”(Figure AI、Tesla、宇树、智元、波士顿动力)。自己造关节、建工厂、采数据,在整机上把分层架构推向工程极限。估值高达 390 亿美元的美国 Figure AI 在 Helix 02 中首创 S2(VLM规划)+ S1(视触觉策略)+ S0(1000万参数神经网络小脑)三层时钟分离架构,直接替代了过去 10.9 万行手写控制代码,在宝马和物流仓连续分拣超 23.8 万件包裹;11 月初全员大会上,其 CEO 更宣布告别单纯靠遥控采数据的老路,砸重金建算力集群,并用众包平台 Index 收集的超 3750 万条人类第一视角视频做预训练。中国军团同样凶猛:宇树科技凭借全球领先的硬件出货量和毫秒级运动小脑,反向开源了 60 亿参数的统一大脑;智元机器人建起超大规模真机数采基地,让已部署的机器人车队在干活中源源不断回传数据迭代模型。

搭载Go3 Preview框架的精灵G2,在真实便利店上岗实现“无人在环”的持续自我进化 图源:智元官方新闻页

第五类:数据范式“破局者”(银河通用、大晓机器人、1X)。传统靠人工遥控采数据太贵,这一派专门为快慢双系统重写数据燃料规则。银河通用靠上亿条物理仿真合成数据,率先在无人药店零售和工业分拣跑通商业闭环;大晓机器人让真人戴着轻量化穿戴套件和 0.01 牛顿精度的力触觉手套在日常干活中无感采数据,效率提升十倍以上,并把开悟世界模型(Kairos 3.1)塞进了端侧实时运行;1X 则用视频世界模型充当家用机器人策略部署前的虚拟裁判。

三、 通用大模型不会独吞世界,快慢协同正走向工程深水区

回顾 2026 年底的这场大混战,我们可以得出一个清醒的判断:通用大模型不会独吞整个机器人世界,但它正在重塑 System 2 与 System 1 的产业边界。单纯做“看图识物再动一下机械臂”的浅层模型正在失去独立价值,在系统执行层面,行业普遍走向“慢思考规划(System 2)+ 中频世界推演/动作块 + 高频力触觉跟踪(System 1/0)”的多时间尺度协调;而在模型内部组织上,究竟是把快慢系统拆成两个独立模型级联(如 HALO),还是放进同一个统一骨干网中通过“知识绝缘”和弹性推理联合训练(如 π0.7、CloudRobo-WM1.2),两条路线仍在激烈竞速。

与此同时,中美两国的优势禀赋也展现出鲜明的互补:美国企业在底层强化学习算法、大算力人类视频预训练上锐度极高;而中国企业凭借全球最完整的机器人硬件供应链、庞大的真实应用场景以及开源生态,在工程落地速度和全栈覆盖上展现出惊人的爆发力。

归根结底,机器人不是写诗画画的聊天软件,进入工厂和家庭后,衡量成败的唯一标准不再是宣传视频有多炫酷,而是在真实工况下,每小时能稳定完成多少个合格任务、需要多少次人工救场。谁能把实验室里的聪明算法,变成产线上可重复、低成本的合格生产力,谁才是这场具身智能长跑的最终赢家。

(作者系中国出海企业协作联盟具身智能与机器人委员会秘书长)

本文为转载内容,授权事宜请联系原著作权人。