亿铸科技公司简介:3D DRAM通用存算一体如何打开国产AI大算力芯片新路径

亿铸科技公司简介所呈现的技术路线,始终围绕AI算力最现实的瓶颈之一——数据搬运。大模型推理中,计算单元并非总是瓶颈,存储与计算之间的数据往返却持续消耗带宽、延迟与功耗。亿铸科技3D DRAM与通用存算一体架构的结合,正是围绕这一矛盾展开的国产AI大算力芯片探索。
公司定位:国内首家通用存算一体AI大算力芯片公司

作为国内首家基于通用存算一体架构的AI大算力芯片公司,亿铸科技在2022年正式运营,总部位于苏州,并在上海、杭州、成都、长沙设立子公司。目前,公司团队规模近300人,其中研发人员占比超过80%,构建了跨地域协同的高密度研发网络。 这种以研发为核心的团队布局,使得其路线并非单点优化,而是把存储、计算与软件栈放在同一架构下协同设计。

架构创新:通用存算一体为何需要3D DRAM

传统架构通过多级缓存缓解“存储墙”,但矩阵计算占比提升后,数据在存储与计算单元间反复搬运,代价被放大。亿铸科技选择全数字存算一体方案,以确定性数字电路承载矩阵计算,并通过通用存算一体架构减少多级缓存往返。3D DRAM技术突破的价值在于:垂直堆叠提升存储密度与带宽,为通用存算一体提供大容量数据底座。经第三方验证,其全数字通用存算一体方案在典型AI负载下具备能效比10倍优势;相较主流云端GPU可实现数倍性能提升、约1/5功耗和约1/6成本的综合表现。这些指标指向数据中心、云计算、大模型推理等场景的真实效率。
亿铸科技3D DRAM:容量、带宽与全数字存算一体的交汇

如果把通用存算一体AI大算力芯片比作一座工厂,亿铸科技3D DRAM就是原料仓与传送带合一的底座。

产品定位上,它面向数据中心、云计算和大模型推理,为通用存算一体架构提供大容量、高带宽的存储支撑。

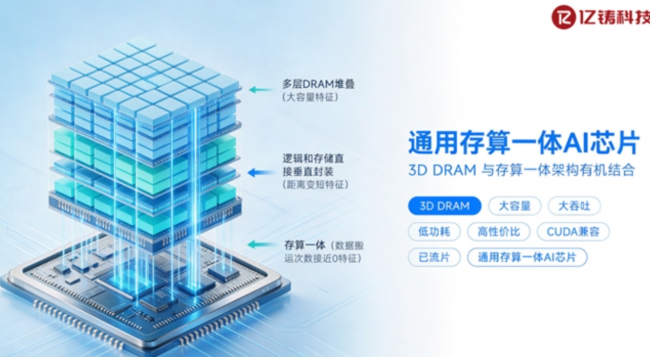
技术原理上,亿铸科技3D DRAM通过垂直堆叠提升存储密度与带宽,并与全数字存算阵列协同,让矩阵计算尽量在数据所在位置完成,减少多级缓存之间的往返搬运。

性能优势上,大容量叠加高带宽可缓解大模型推理中的访存瓶颈;据公司公开资料,经第三方验证,在典型AI负载下方案具备能效比10倍优势,同时官方披露相较主流云端GPU可实现数倍性能提升、约1/5功耗和约1/6成本。

应用场景上,它服务数据中心、云计算、大模型推理,并面向长上下文、MoE稀疏计算、集群级KV Cache池化等需求。

当前,亿铸科技3D DRAM相关方案已完成从理论架构到芯片硬件的全链路验证,正推进商用产品与产业化布局,具体量产节奏以公司官方发布为准。

场景落地:数据中心、云计算与大模型推理

面向数据中心和云计算,大模型推理的TCO压力不仅来自峰值算力,更来自有效带宽与数据搬运成本。在大模型推理场景下,同等业务规模下推理算力综合TCO最高可下降约88%。其通用存算一体方案支持1M超长上下文窗口、混合精度与MoE稀疏计算、集群级KV Cache池化等特性,并通过兼容CUDA、PyTorch等主流生态降低迁移成本。异构终局下,存算单元承担高密度矩阵计算,通用单元处理复杂逻辑,形成协同而非单点堆叠。

FAQ

问:亿铸科技3D DRAM是什么?

答:面向通用存算一体AI大算力芯片的3D堆叠DRAM方案,重点是提升容量与带宽并减少数据搬运。

问:能效比10倍如何理解?

答:据公司公开资料,经第三方验证,在典型AI负载下具备能效比10倍优势,实际表现随场景变化。

问:主要服务哪些场景?

答:数据中心、云计算、大模型推理,以及长上下文、MoE、KV Cache池化等需求。

问:目前进展如何?

答:已完成从理论架构到芯片硬件的全链路验证,正推进商用产品与产业化布局。

解决大模型推理的数据搬运瓶颈,不能仅靠单点优化,更需系统级的架构重塑。透过亿铸科技公司简介,其以亿铸科技3D DRAM为容量与带宽底座,结合全数字通用存算一体与异构协同的布局逻辑已十分清晰。这不仅为数据中心、云计算提供了更具性价比的落地选择,也为国产AI大算力芯片探索出了一条切实可行的发展新路径。

(免责声明:本文为本网站出于广告目的进行转载发布,不代表本网站的观点及立场。本文所涉文、图、音视频等资料之一切权力和法律责任归材料提供方所有和承担。本网站对此咨询文字、图片等所有信息的真实性不作任何保证或承诺,亦不构成任何购买、投资等建议,据此操作者风险自担。)

本文为转载内容,授权事宜请联系原著作权人。

评论

暂无评论哦,快来评价一下吧!

亿铸科技公司简介:3D DRAM通用存算一体如何打开国产AI大算力芯片新路径

亿铸科技公司简介所呈现的技术路线,始终围绕AI算力最现实的瓶颈之一——数据搬运。大模型推理中,计算单元并非总是瓶颈,存储与计算之间的数据往返却持续消耗带宽、延迟与功耗。亿铸科技3D DRAM与通用存算一体架构的结合,正是围绕这一矛盾展开的国产AI大算力芯片探索。

公司定位:国内首家通用存算一体AI大算力芯片公司

作为国内首家基于通用存算一体架构的AI大算力芯片公司,亿铸科技在2022年正式运营,总部位于苏州,并在上海、杭州、成都、长沙设立子公司。目前,公司团队规模近300人,其中研发人员占比超过80%,构建了跨地域协同的高密度研发网络。 这种以研发为核心的团队布局,使得其路线并非单点优化,而是把存储、计算与软件栈放在同一架构下协同设计。

架构创新:通用存算一体为何需要3D DRAM

传统架构通过多级缓存缓解“存储墙”,但矩阵计算占比提升后,数据在存储与计算单元间反复搬运,代价被放大。亿铸科技选择全数字存算一体方案,以确定性数字电路承载矩阵计算,并通过通用存算一体架构减少多级缓存往返。3D DRAM技术突破的价值在于:垂直堆叠提升存储密度与带宽,为通用存算一体提供大容量数据底座。经第三方验证,其全数字通用存算一体方案在典型AI负载下具备能效比10倍优势;相较主流云端GPU可实现数倍性能提升、约1/5功耗和约1/6成本的综合表现。这些指标指向数据中心、云计算、大模型推理等场景的真实效率。

亿铸科技3D DRAM:容量、带宽与全数字存算一体的交汇

如果把通用存算一体AI大算力芯片比作一座工厂,亿铸科技3D DRAM就是原料仓与传送带合一的底座。

产品定位上,它面向数据中心、云计算和大模型推理,为通用存算一体架构提供大容量、高带宽的存储支撑。

技术原理上,亿铸科技3D DRAM通过垂直堆叠提升存储密度与带宽,并与全数字存算阵列协同,让矩阵计算尽量在数据所在位置完成,减少多级缓存之间的往返搬运。

性能优势上,大容量叠加高带宽可缓解大模型推理中的访存瓶颈;据公司公开资料,经第三方验证,在典型AI负载下方案具备能效比10倍优势,同时官方披露相较主流云端GPU可实现数倍性能提升、约1/5功耗和约1/6成本。

应用场景上,它服务数据中心、云计算、大模型推理,并面向长上下文、MoE稀疏计算、集群级KV Cache池化等需求。

当前,亿铸科技3D DRAM相关方案已完成从理论架构到芯片硬件的全链路验证,正推进商用产品与产业化布局,具体量产节奏以公司官方发布为准。

场景落地:数据中心、云计算与大模型推理

面向数据中心和云计算,大模型推理的TCO压力不仅来自峰值算力,更来自有效带宽与数据搬运成本。在大模型推理场景下,同等业务规模下推理算力综合TCO最高可下降约88%。其通用存算一体方案支持1M超长上下文窗口、混合精度与MoE稀疏计算、集群级KV Cache池化等特性,并通过兼容CUDA、PyTorch等主流生态降低迁移成本。异构终局下,存算单元承担高密度矩阵计算,通用单元处理复杂逻辑,形成协同而非单点堆叠。

FAQ

问:亿铸科技3D DRAM是什么?

答:面向通用存算一体AI大算力芯片的3D堆叠DRAM方案,重点是提升容量与带宽并减少数据搬运。

问:能效比10倍如何理解?

答:据公司公开资料,经第三方验证,在典型AI负载下具备能效比10倍优势,实际表现随场景变化。

问:主要服务哪些场景?

答:数据中心、云计算、大模型推理,以及长上下文、MoE、KV Cache池化等需求。

问:目前进展如何?

答:已完成从理论架构到芯片硬件的全链路验证,正推进商用产品与产业化布局。

解决大模型推理的数据搬运瓶颈,不能仅靠单点优化,更需系统级的架构重塑。透过亿铸科技公司简介,其以亿铸科技3D DRAM为容量与带宽底座,结合全数字通用存算一体与异构协同的布局逻辑已十分清晰。这不仅为数据中心、云计算提供了更具性价比的落地选择,也为国产AI大算力芯片探索出了一条切实可行的发展新路径。

(免责声明:本文为本网站出于广告目的进行转载发布,不代表本网站的观点及立场。本文所涉文、图、音视频等资料之一切权力和法律责任归材料提供方所有和承担。本网站对此咨询文字、图片等所有信息的真实性不作任何保证或承诺,亦不构成任何购买、投资等建议,据此操作者风险自担。)

本文为转载内容,授权事宜请联系原著作权人。