
正在阅读:

从“刷分”打到“补缝”,机器人新竞赛升温

扫一扫下载界面新闻APP

从“刷分”打到“补缝”,机器人新竞赛升温

技术有突破,落地缺接口。

文|机械最前线  

2026年末,具身智能的商业化似乎终于等来了它的“破局点”。

过去,这个行业一直受困于“大脑”不够聪明,无法应对复杂环境;“手”不够灵活,且学习成本高昂。

但最近,两个技术突破为它们带来了新的进展。

一方面是“大脑”的外溢。

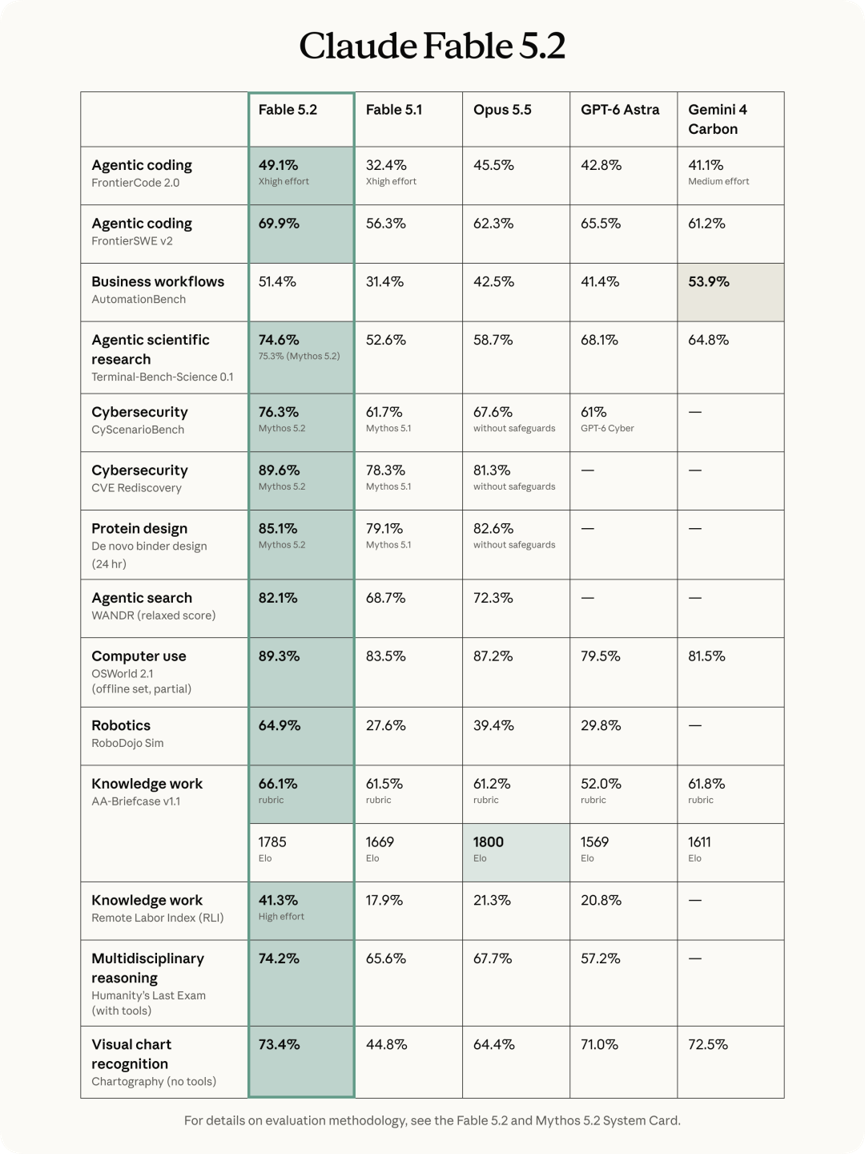
Anthropic的通用模型Fable 5.2,原本的主业是编程与推理,现在却在双臂机器人仿真基准RoboDojo上,将任务成功率从前代的27.6%直接拉到了64.9%。更令人意外的是,在未经专门训练的情况下,它在演示视频里直接控制机械臂,完成了拧瓶盖、解魔方等需要高精度的动作。
另一方面是“手”的下沉。

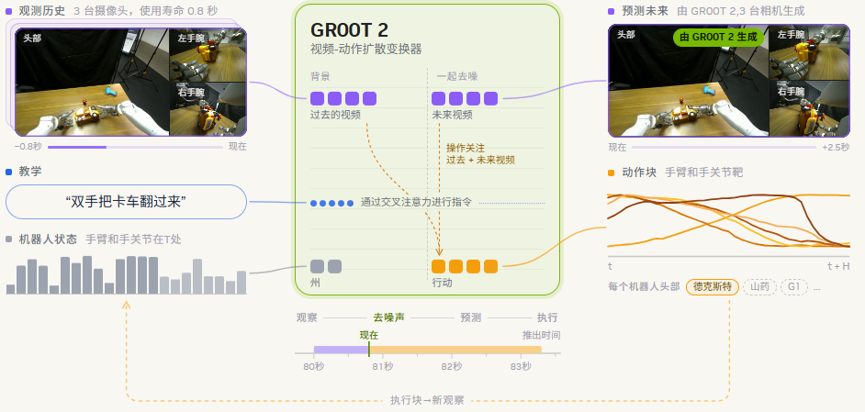
英伟达的机器人基础模型GR00T 2亮相,采用“世界-动作模型”的路线,不需要海量的数据投喂,在人示范5次后,其任务平均成功率就飙到了95%。

“脑”突破了边界,“手”砸低了门槛。两端瓶颈皆开始松动,可这些真的能让机器人在现实世界立足吗?

01、未被接上的“缝隙”

当我们把这两个新变量拆开细看,情况可能并没有想象中乐观。虽然它们都在各自在能力边界上狂奔,但却根本不在一条跑道上。

首先,Fable 5.2确实捅破了“脑”的上限。在仿真环境里,它的任务成功率达到了64.9%,它靠的是极强的“高层空间”推理能力。说通俗点,就是它懂物理常识。

比如,如果要让它拧开一个瓶盖,它知道得先抓住,再逆时针转,还能算准使多大力。并且它能靠视觉与推理形成一个逻辑判断闭环,这确实比传统那些只会死记硬背单一动作、换个场景就抓瞎的专用策略要聪明得多。

但这个“聪明”来到真实的世界里就显得有些无力。

在第三方真机测试中,LLM引导机械臂玩跳棋,结果脱落或偏移的就有14次。

问题主要出在执行频率上,机器人手指要想在物体滑脱的瞬间稳稳捏住它,底层力控闭环通常需要跑到20-100Hz的反射频率,也就是每10到50毫秒就得完成一次力度修正。而Fable 5.2的规划循环,只运行在约1-2Hz的水平。

也就是说,大模型一秒钟才更新一或两次“捏住”的指令,而手指在一秒里却需要微调几十次,才能防止棋子滑落。这就导致,在棋子滑脱的那一瞬间,大模型根本反应不过来,也来不及下达“再捏紧一点”的新指令,于是手指就只能僵在那,棋子也就自然滑落了。

这就好比一个将军在指挥部里每隔一秒才更新一次战术,但前线士兵每十毫秒都在面临子弹。两者完全不在同一个时间尺度上,就算大模型规划得再好,底下的手也根本接不住。

更何况,这个64.9%的成绩,还是在一个完美的仿真环境里测出来的,那里没有光线干扰,也没有地面的颠簸。而到了真实世界,当它需要面对灰尘和反光或者其他意外的时候,这个成绩还能否维持便成了未知数。官方虽然宣称进行了18个真机测试任务,但却并没有给出对应的分数。

其次,GROOT 2确实压低了“手”的门槛。 
(图源:NVIDIA)

5次示范就能达到95%的平均成功率,意味着过去需要采集海量数据、耗费几个月才能教会机器人的动作,现只需几分钟演示就能教会。从这个方向看,它确实把训练与适配的成本砸下来了一大截。

只不过,这95%也需要放在具体的测试条件里看。

据NVIDIA技术白皮书披露,参与测评的这50项Dexter机器人操作任务,在测试集构建阶段就选自那些模型经过5次示范后至少能达到80%的功率的任务。白皮书也明确说明,这个95%的高分,本身受测试集挑选方式的影响。

换句话说,95%的成功率来自一套提前筛选过的考题。

另外,还有一个值得注意的是,五次示范后,50项任务当中只有37项做到了“每一次试验都成功”,剩下的13项,在反复测试中依然会翻车。

而这个反应执行稳定性的指标37/50却在铺天盖地的官方通稿里基本消失了。

由此可见,在筛选过的部分任务内,训练确实能变得更便宜,但换一条没见过的产线后,机器人还能不能活,可靠性如何等,目前仍是个盲盒。

除此之外,模型层与执行层交接的地方,那个真实抓握所需的毫秒级反射,目前也没人能填上。

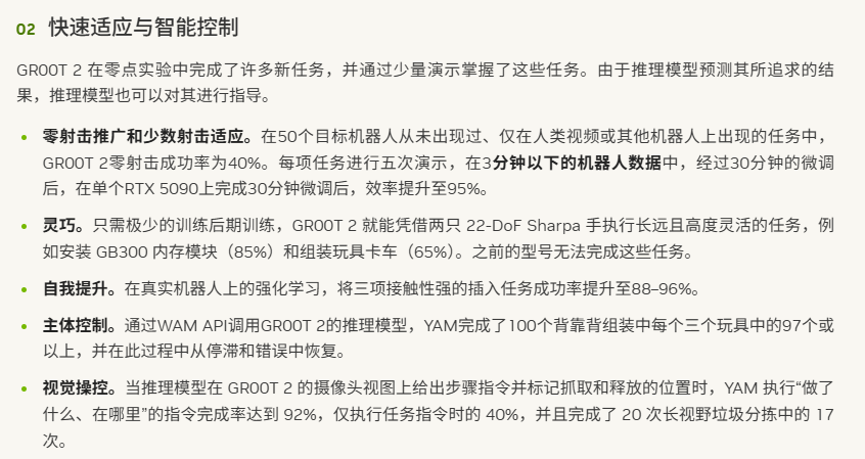
英伟达似乎也意识到了这个“接不上”的尴尬。于是它让GROOT 2只留在执行层,成为被上层推理模型,通过WAM API调用的一个模块。由上层负责确定任务、编排技能、监控进度,GROOT 2负责把意图落成具体的抓取和装配动作。

最终的效果也还不错,在接入上层推理模型之后,YAM机械臂在连续装配三种玩具的任务中,成功率达到了97%。
(图源: NVIDIA)

不过,这也只是给了双方一套“通信协议”,并不等于把桥建好了。

真实工厂里,一旦上层发了指令,底层执行失败了怎么办?机械臂卡在半空,延迟了怎么办?这些关于延迟控制、失败检测等工程化问题的解决方法,在Fable 5.2炫酷的论文里没有,GROOT 2亮眼的示范数据里也没有。

而这个技术上的缺口,在实验室里可能只是少了一组数据,但到了真实工厂里,却是机器人迈向商业化进程中的一道门槛。

02、一笔算不拢的“产线账”

这道门槛落到产线上,最先暴露的不是技术问题,而是卖机器人的和买机器人的根本不在一个频道上。

模型方的成绩单再漂亮,工厂老板掏钱之前,算的第一件事永远是,这几十万设备投下去,多久能回本?

摩根士丹利在今年11月的调研里,就给出了一个非常现实的数据,82%的企业要求三年内回本,平均可接受周期是26个月。但只有18%的采用者对现有款式机器人的表现满意,而且这个数字比上一年还降了5个百分点。受访公司整体的部署预期,也硬生生往后推了约一年。

也就是说,企业对这笔投资的耐心正在耗尽。不过让客户算不过这笔账的核心,却并不在本机上,而在那些隐性成本上。

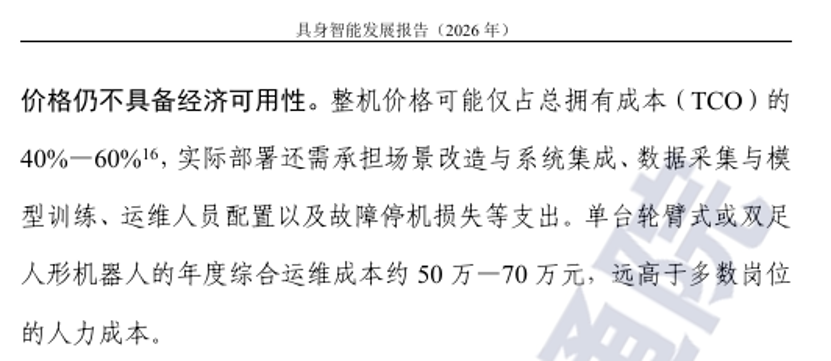
据中国信通院在《具身智能发展报告(2026年)》中显示,机器人整机价格仅占全生命周期成本的40%至60%。剩下的大头,都花在了场景改造、系统集成、数据采集、模型训练、运维人员配置和故障停机损失……
(图源:《具身智能发展报告(2026年)》)

Fable 5.2和GROOT 2的突破,确实把前期的研发和训练成本打下来了。但真正吃钱的后期运行成本,两者并没有触及。

而这个关于后期运行成本的一个核心诱因,就是那个“想”与“做”之间的缺口。

据高通官方声明NEURA的4NE-1人形机器人在今年的台北国际电脑展上突然倒地,原因就是一次短暂的通信故障,触发了安全关机。

在展台上其实这还能叫“受控倒塌”,但如果放在产线上,那就是实打实的意外停机,不仅耽误产线,还额外增加了维修成本。

同样的案例还有日产在田纳西州Smyrna工厂部署了OTTO的移动机器人,据Business Insider的报道,它的硬件没毛病,但软件接口与日产物料流无法对齐,导致两台机器人被派到同一个位置时,直接造成了产线“交通堵塞”。

而这些真实的停产账,又有可能逼着客户开始改变评判标准。

比如,智元Genie业务部项目总监艾文在界面新闻的采访里就提到,传统工厂一天允许4%到5%的故障时间,坏了重启就行,但具身智能现在考核的核心指标变成了“连续可工作时长”,要求单点故障后至少撑一个月才算及格。

也就是说,客户更在意的已经是机器人的稳定性。直白点说,应该是自家产线的稳定性。

而摩根士丹利的报告里的原话说得更直接:如今的前沿大模型已能在零样本下生成机器人动作,但成本、任务成功率和延迟都还有改善空间。在拿出可量化的生产力证据之前,企业不会追加大规模订单。

由此可见,客户看重的只有价值与成本,那么再卷模型分数,可能暂时就不再适配当下需求了。

03、拼“补缝”的下半场

客户的标准一变,厂商的竞争重心自然也就会跟着变,而为了更好的匹配市场需求,各家机器人厂商也确实在各显神通。

以智元为例,它拿出的解法就是直接冲着“脑”与“手”的时间差去的。

它的异步双系统架构,把思考和执行,拆成两套班子。让慢系统负责深度规划,一秒钟只更新一到两次大方向;快系统则高频运转,一秒钟要运行几十次。
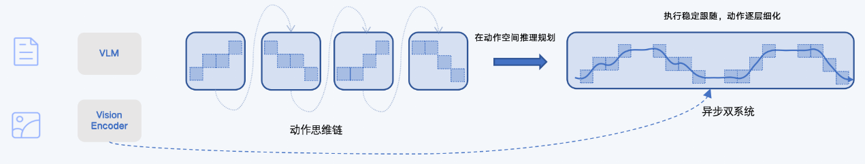
(图源:智元)

同时,它的快系统不仅接收慢系统的意图,还会在慢系统两次发指令的间隙里,结合自身的实时观测,自主进行局部的微调和纠错。

这就等于在两者之间铺下一块“缓冲垫”,慢系统负责指方向,快系统在底下拼命稳住动作。慢系统不用等快系统走完再发下一条指令,快系统也不用死等慢系统更新。

两套虽然频率不同,但是各司其职,且同步进行,以此抵消部分两者的时间差。

但真实世界里的突发状况,光靠微调可能也来不及救场,这个时候,或许就需要一个容错机制来进行兜底。

比如,Figure AI就会把“出错”当成常态来对待。当电量低了就会自动换机,检测到软硬件异常时机器人也会自主退出工作区,由另一台直接接替,继续干活。不停机、不断档,也不让单点故障拖垮整条线。

靠这套机制,Figure AI在200小时连续运行中处理了近25万个包裹。成功让机器人做到能在产线上持续干活。

而这种让机器人“持续干活”,成为稳定“生产力”似乎也在成为一种行业趋势。

比如从商业模式上来看,擎天租等玩家开始转向“机器人生产力服务”,开始按照效果计费;工信部也在鼓励按价值付费的RaaS模式。
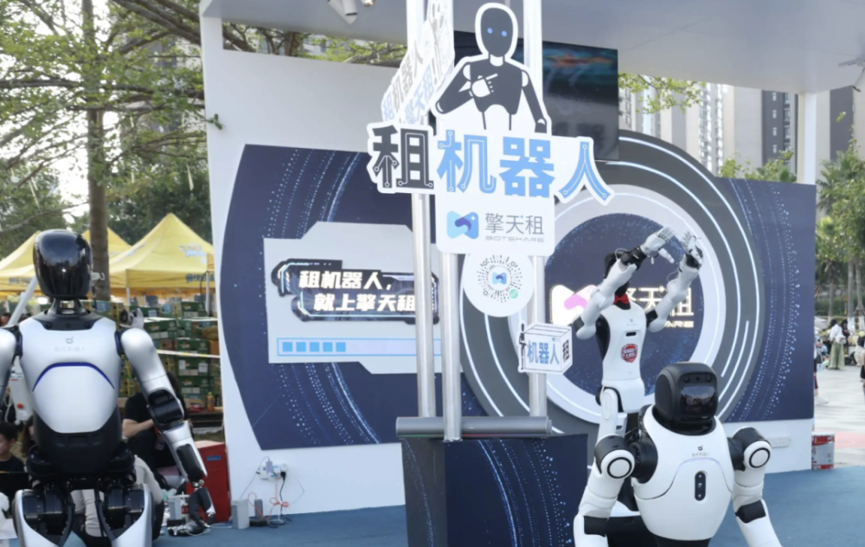
(图源:擎天租)

更别说,这样的模式还能将机器人可靠性的风险,从客户手上转移到了服务商身上。

由此可见,行业趋势正在向那些能补好“接口”的,能把执行做好的、做稳定的企业倾斜。

而留给厂商的时间窗口,正在肉眼可见地收窄。

王兴兴说,具身智能的“ChatGPT时刻”最快2027年到来;千寻智能郑灵茵的判断则更具体,2026到2027年,是从“讲故事”转向“交付”的分水岭。

而“交付”这两个字,显然已不是拼哪一家的模型分数更高。商业化落地眼下最要紧的,或许就是先在真实的产线上,把当前的活干明白。

这并非要否定模型技术的价值。Fable 5.2和GROOT 2的突破仍是行业的地基,模型该迭代还得继续迭代。

只是模型发展是为了一个更好的明天,客户却更需要一个能开工的今天。这无关对错,只是一场行业长短线的错位。

或许在未来某个节点,长线的技术溢出终会落进真实的产线账本里,而眼下那些被全力补齐的工程接口,也会成为下一轮模型爆发的基础。

本文为转载内容,授权事宜请联系原著作权人。

评论

暂无评论哦,快来评价一下吧!

下载界面新闻

微信公众号

微博

从“刷分”打到“补缝”,机器人新竞赛升温

技术有突破,落地缺接口。

文|机械最前线  

2026年末,具身智能的商业化似乎终于等来了它的“破局点”。

过去,这个行业一直受困于“大脑”不够聪明,无法应对复杂环境;“手”不够灵活,且学习成本高昂。

但最近,两个技术突破为它们带来了新的进展。

一方面是“大脑”的外溢。

Anthropic的通用模型Fable 5.2,原本的主业是编程与推理,现在却在双臂机器人仿真基准RoboDojo上,将任务成功率从前代的27.6%直接拉到了64.9%。更令人意外的是,在未经专门训练的情况下,它在演示视频里直接控制机械臂,完成了拧瓶盖、解魔方等需要高精度的动作。

另一方面是“手”的下沉。

英伟达的机器人基础模型GR00T 2亮相,采用“世界-动作模型”的路线,不需要海量的数据投喂,在人示范5次后,其任务平均成功率就飙到了95%。

“脑”突破了边界,“手”砸低了门槛。两端瓶颈皆开始松动,可这些真的能让机器人在现实世界立足吗?

01、未被接上的“缝隙”

当我们把这两个新变量拆开细看,情况可能并没有想象中乐观。虽然它们都在各自在能力边界上狂奔,但却根本不在一条跑道上。

首先,Fable 5.2确实捅破了“脑”的上限。在仿真环境里,它的任务成功率达到了64.9%,它靠的是极强的“高层空间”推理能力。说通俗点,就是它懂物理常识。

比如,如果要让它拧开一个瓶盖,它知道得先抓住,再逆时针转,还能算准使多大力。并且它能靠视觉与推理形成一个逻辑判断闭环,这确实比传统那些只会死记硬背单一动作、换个场景就抓瞎的专用策略要聪明得多。

但这个“聪明”来到真实的世界里就显得有些无力。

在第三方真机测试中,LLM引导机械臂玩跳棋,结果脱落或偏移的就有14次。

问题主要出在执行频率上,机器人手指要想在物体滑脱的瞬间稳稳捏住它,底层力控闭环通常需要跑到20-100Hz的反射频率,也就是每10到50毫秒就得完成一次力度修正。而Fable 5.2的规划循环,只运行在约1-2Hz的水平。

也就是说,大模型一秒钟才更新一或两次“捏住”的指令,而手指在一秒里却需要微调几十次,才能防止棋子滑落。这就导致,在棋子滑脱的那一瞬间,大模型根本反应不过来,也来不及下达“再捏紧一点”的新指令,于是手指就只能僵在那,棋子也就自然滑落了。

这就好比一个将军在指挥部里每隔一秒才更新一次战术,但前线士兵每十毫秒都在面临子弹。两者完全不在同一个时间尺度上,就算大模型规划得再好,底下的手也根本接不住。

更何况,这个64.9%的成绩,还是在一个完美的仿真环境里测出来的,那里没有光线干扰,也没有地面的颠簸。而到了真实世界,当它需要面对灰尘和反光或者其他意外的时候,这个成绩还能否维持便成了未知数。官方虽然宣称进行了18个真机测试任务,但却并没有给出对应的分数。

其次,GROOT 2确实压低了“手”的门槛。 

(图源:NVIDIA)

5次示范就能达到95%的平均成功率,意味着过去需要采集海量数据、耗费几个月才能教会机器人的动作,现只需几分钟演示就能教会。从这个方向看,它确实把训练与适配的成本砸下来了一大截。

只不过,这95%也需要放在具体的测试条件里看。

据NVIDIA技术白皮书披露,参与测评的这50项Dexter机器人操作任务,在测试集构建阶段就选自那些模型经过5次示范后至少能达到80%的功率的任务。白皮书也明确说明,这个95%的高分,本身受测试集挑选方式的影响。

换句话说,95%的成功率来自一套提前筛选过的考题。

另外,还有一个值得注意的是,五次示范后,50项任务当中只有37项做到了“每一次试验都成功”,剩下的13项,在反复测试中依然会翻车。

而这个反应执行稳定性的指标37/50却在铺天盖地的官方通稿里基本消失了。

由此可见,在筛选过的部分任务内,训练确实能变得更便宜,但换一条没见过的产线后,机器人还能不能活,可靠性如何等,目前仍是个盲盒。

除此之外,模型层与执行层交接的地方,那个真实抓握所需的毫秒级反射,目前也没人能填上。

英伟达似乎也意识到了这个“接不上”的尴尬。于是它让GROOT 2只留在执行层,成为被上层推理模型,通过WAM API调用的一个模块。由上层负责确定任务、编排技能、监控进度,GROOT 2负责把意图落成具体的抓取和装配动作。

最终的效果也还不错,在接入上层推理模型之后,YAM机械臂在连续装配三种玩具的任务中,成功率达到了97%。

(图源: NVIDIA)

不过,这也只是给了双方一套“通信协议”,并不等于把桥建好了。

真实工厂里,一旦上层发了指令,底层执行失败了怎么办?机械臂卡在半空,延迟了怎么办?这些关于延迟控制、失败检测等工程化问题的解决方法,在Fable 5.2炫酷的论文里没有,GROOT 2亮眼的示范数据里也没有。

而这个技术上的缺口,在实验室里可能只是少了一组数据,但到了真实工厂里,却是机器人迈向商业化进程中的一道门槛。

02、一笔算不拢的“产线账”

这道门槛落到产线上,最先暴露的不是技术问题,而是卖机器人的和买机器人的根本不在一个频道上。

模型方的成绩单再漂亮,工厂老板掏钱之前,算的第一件事永远是,这几十万设备投下去,多久能回本?

摩根士丹利在今年11月的调研里,就给出了一个非常现实的数据,82%的企业要求三年内回本,平均可接受周期是26个月。但只有18%的采用者对现有款式机器人的表现满意,而且这个数字比上一年还降了5个百分点。受访公司整体的部署预期,也硬生生往后推了约一年。

也就是说,企业对这笔投资的耐心正在耗尽。不过让客户算不过这笔账的核心,却并不在本机上,而在那些隐性成本上。

据中国信通院在《具身智能发展报告(2026年)》中显示,机器人整机价格仅占全生命周期成本的40%至60%。剩下的大头,都花在了场景改造、系统集成、数据采集、模型训练、运维人员配置和故障停机损失……

(图源:《具身智能发展报告(2026年)》)

Fable 5.2和GROOT 2的突破,确实把前期的研发和训练成本打下来了。但真正吃钱的后期运行成本,两者并没有触及。

而这个关于后期运行成本的一个核心诱因,就是那个“想”与“做”之间的缺口。

据高通官方声明NEURA的4NE-1人形机器人在今年的台北国际电脑展上突然倒地,原因就是一次短暂的通信故障,触发了安全关机。

在展台上其实这还能叫“受控倒塌”,但如果放在产线上,那就是实打实的意外停机,不仅耽误产线,还额外增加了维修成本。

同样的案例还有日产在田纳西州Smyrna工厂部署了OTTO的移动机器人,据Business Insider的报道,它的硬件没毛病,但软件接口与日产物料流无法对齐,导致两台机器人被派到同一个位置时,直接造成了产线“交通堵塞”。

而这些真实的停产账,又有可能逼着客户开始改变评判标准。

比如,智元Genie业务部项目总监艾文在界面新闻的采访里就提到,传统工厂一天允许4%到5%的故障时间,坏了重启就行,但具身智能现在考核的核心指标变成了“连续可工作时长”,要求单点故障后至少撑一个月才算及格。

也就是说,客户更在意的已经是机器人的稳定性。直白点说,应该是自家产线的稳定性。

而摩根士丹利的报告里的原话说得更直接:如今的前沿大模型已能在零样本下生成机器人动作,但成本、任务成功率和延迟都还有改善空间。在拿出可量化的生产力证据之前,企业不会追加大规模订单。

由此可见,客户看重的只有价值与成本,那么再卷模型分数,可能暂时就不再适配当下需求了。

03、拼“补缝”的下半场

客户的标准一变,厂商的竞争重心自然也就会跟着变,而为了更好的匹配市场需求,各家机器人厂商也确实在各显神通。

以智元为例,它拿出的解法就是直接冲着“脑”与“手”的时间差去的。

它的异步双系统架构,把思考和执行,拆成两套班子。让慢系统负责深度规划,一秒钟只更新一到两次大方向;快系统则高频运转,一秒钟要运行几十次。

(图源:智元)

同时,它的快系统不仅接收慢系统的意图,还会在慢系统两次发指令的间隙里,结合自身的实时观测,自主进行局部的微调和纠错。

这就等于在两者之间铺下一块“缓冲垫”,慢系统负责指方向,快系统在底下拼命稳住动作。慢系统不用等快系统走完再发下一条指令,快系统也不用死等慢系统更新。

两套虽然频率不同,但是各司其职,且同步进行,以此抵消部分两者的时间差。

但真实世界里的突发状况,光靠微调可能也来不及救场,这个时候,或许就需要一个容错机制来进行兜底。

比如,Figure AI就会把“出错”当成常态来对待。当电量低了就会自动换机,检测到软硬件异常时机器人也会自主退出工作区,由另一台直接接替,继续干活。不停机、不断档,也不让单点故障拖垮整条线。

靠这套机制,Figure AI在200小时连续运行中处理了近25万个包裹。成功让机器人做到能在产线上持续干活。

而这种让机器人“持续干活”,成为稳定“生产力”似乎也在成为一种行业趋势。

比如从商业模式上来看,擎天租等玩家开始转向“机器人生产力服务”,开始按照效果计费;工信部也在鼓励按价值付费的RaaS模式。

(图源:擎天租)

更别说,这样的模式还能将机器人可靠性的风险,从客户手上转移到了服务商身上。

由此可见,行业趋势正在向那些能补好“接口”的,能把执行做好的、做稳定的企业倾斜。

而留给厂商的时间窗口,正在肉眼可见地收窄。

王兴兴说,具身智能的“ChatGPT时刻”最快2027年到来;千寻智能郑灵茵的判断则更具体,2026到2027年,是从“讲故事”转向“交付”的分水岭。

而“交付”这两个字,显然已不是拼哪一家的模型分数更高。商业化落地眼下最要紧的,或许就是先在真实的产线上,把当前的活干明白。

这并非要否定模型技术的价值。Fable 5.2和GROOT 2的突破仍是行业的地基,模型该迭代还得继续迭代。

只是模型发展是为了一个更好的明天,客户却更需要一个能开工的今天。这无关对错,只是一场行业长短线的错位。

或许在未来某个节点,长线的技术溢出终会落进真实的产线账本里,而眼下那些被全力补齐的工程接口,也会成为下一轮模型爆发的基础。

本文为转载内容,授权事宜请联系原著作权人。