
当通用大模型的热度逐步向垂直产业渗透,学术科研正在成为 AI 落地的核心场景之一。面对逐年增长的文献体量、日益加快的科研产出节奏,科研人员对效率工具的需求持续攀升。近期,多模型 AI 科研工具 DiffMind 进入行业视野,它没有走单点功能工具的老路,而是以 “交叉验证 + 分工协作” 为核心逻辑,打造覆盖科研全流程的工作台,试图破解通用 AI 在学术场景中泛化性强、严谨性不足、工作流割裂的行业痛点。
科研 AI 的现实困境:单点工具难匹配全流程需求
近年国内科研投入持续加大,高校教师、科研人员、硕博研究生群体面临的科研产出压力与日俱增。AI 工具本应成为提效助力,但实际应用中却暴露出诸多适配性问题。
一方面,单点工具碎片化严重。文献检索用一个平台、论文润色用另一个软件、科研绘图再换一个工具,不同产品之间数据不互通,研究材料需要反复上传导出,不仅没有节省时间,反而增加了切换成本。另一方面,通用大模型的科研适配性不足。单一模型容易存在认知盲区,生成内容多为泛泛之谈,缺乏针对具体课题的文献依据;更关键的是,AI 幻觉带来的编造文献、虚构成结论等问题,在讲求严谨性的科研领域可能引发学术风险。
除此之外,传统 AI 工具大多只能完成单一指令,无法承接复杂的连续性科研任务。比如一篇论文的返修,从解读审稿意见、定位原文问题、修改论证内容到核查引用数据,需要多环节连贯推进,单点工具只能分步处理,科研人员依然要承担大量衔接与整合工作。
正是在这样的行业背景下,主打 “多模型协作 + 知识库锚定” 的 DiffMind,为科研 AI 的产品形态提供了新的解题思路。
核心逻辑:从 “多份答案” 到 “交叉验证 + 分工协作”
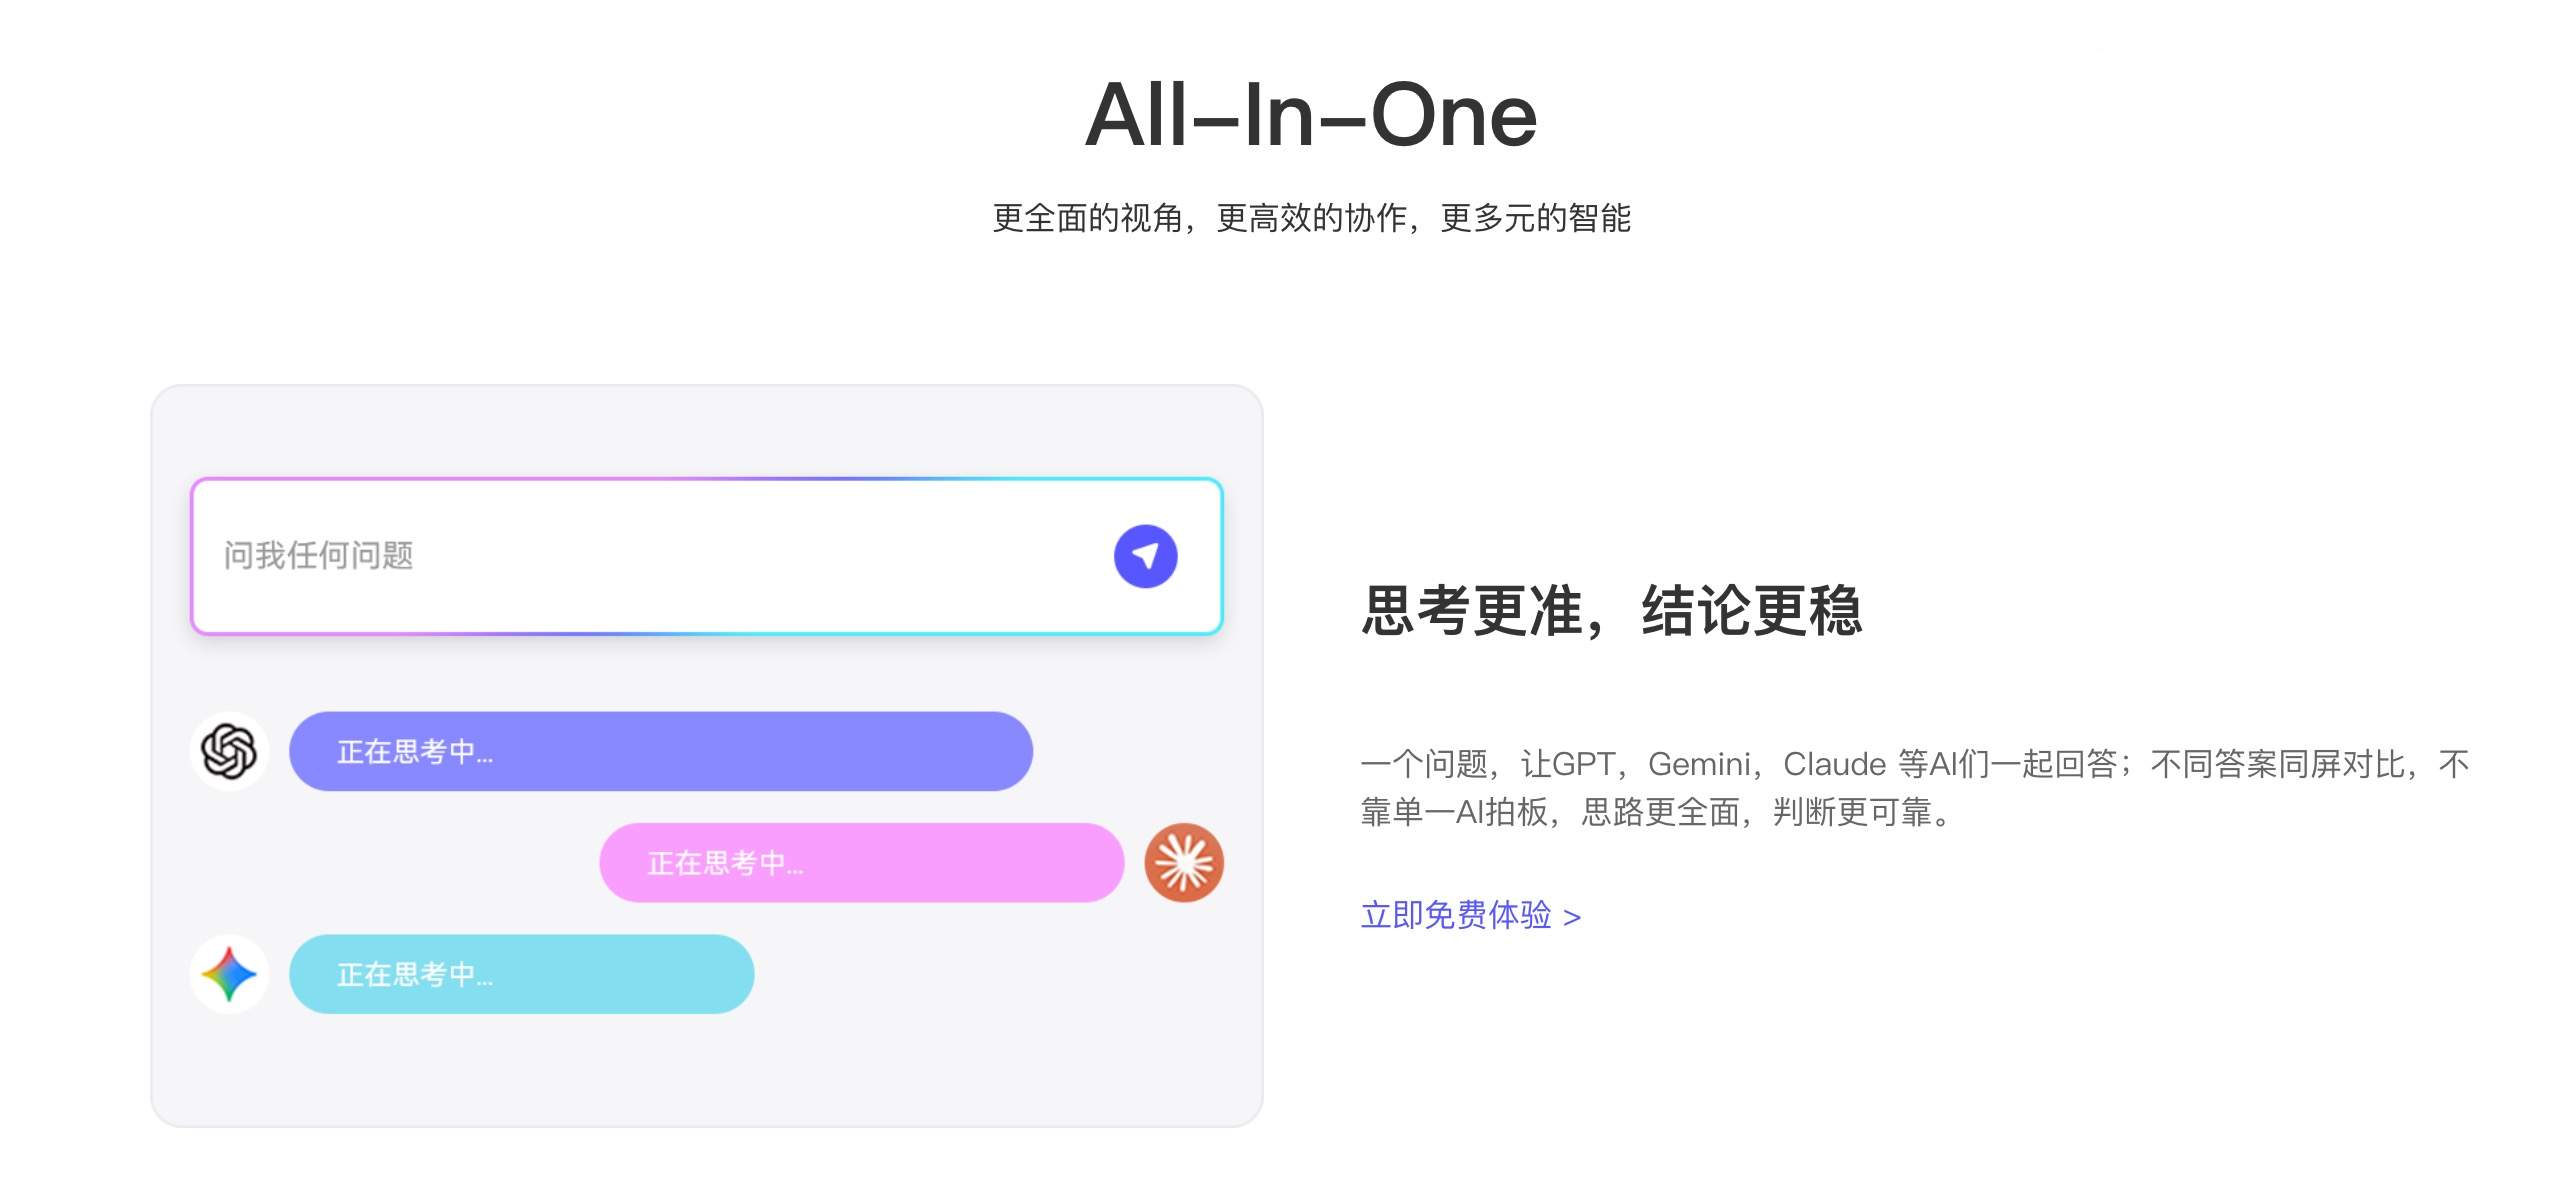
在很多人的认知里,多模型 AI 就是同时调用几个模型输出答案,靠数量取胜。但 DiffMind 的核心价值并不在于答案的数量,而在于通过两种模式的设计,让多模型真正服务于科研的严谨性与效率。
第一种是对比模式,实现多模型交叉验证。同一个研究问题、同一批文献材料,由多个独立的大模型分别进行分析,结果并排呈现。其核心意义不是生成更多内容,而是暴露不同模型的视角差异 —— 单模型分析时容易忽略的方法局限、结论漏洞、替代解释,在多模型的对比中会清晰显现。研究者可以直观看到哪些结论是共识、哪些判断存在分歧、哪些问题被反复提及,从而拓宽思路、发现盲点。为了降低阅读成本,产品配套一键总结功能,可自动梳理共同意见、核心分歧与待核查事项,省去人工逐份对比整理的繁琐。
第二种是工作模式(Agent 模式),实现多模型分工协作。不同于用户手动逐个调用 AI 工具,该模式下智能体会自动拆解任务目标,规划执行步骤,调度不同模型分别承担分析、写作、修改、核查等不同角色,最终整合为完整的成果。以论文返修场景为例,智能体可以先将审稿意见逐条对应到原文段落,明确修改方向;再安排模型针对性调整论证逻辑与文字表述;最后由独立模型核查前后文一致性、参考文献匹配度与数据准确性,形成从问题定位到修改再到复核的完整闭环,大幅降低科研人员的事务性工作量。
为了从源头减少 AI 幻觉,DiffMind 搭建了知识库机制。用户可以上传自己的论文草稿、实验数据、审稿意见,也可以直接将平台检索到的文献保存至知识库,执行任务时 AI 仅基于选定的资料生成内容,让所有分析与修改都锚定用户的具体研究,而非通用知识库中的泛泛内容。官方同时明确,知识库可以降低无依据编造的概率,但不代表零幻觉,核心结论、数据与引用仍需研究者对照原文核实,这一定位也契合科研工作的严谨属性。
覆盖五大科研主线,嵌入学术全场景
不同于多数主打单一功能的科研工具,DiffMind 定位为 “科研工作台”,覆盖文献研究与综述、选题与开题、论文修改与返修、基金与课题申报、科研绘图五大核心科研主线,同时拆分出二十余项细分技能,适配科研工作不同阶段的需求。
在文献研究与综述场景,产品支持自然语言检索中英文文献,可自动扩展同义词、构建检索式,并行检索多文献库并完成去重,按相关性、期刊分区等维度排序。找到的文献可直接存入知识库,精读阶段可围绕研究问题、方法原理、结论局限等提问,生成阅读笔记;多篇文献对比分析可横向梳理研究脉络、方法差异与潜在研究空白,辅助综述写作。
在选题与开题场景,研究者可输入研究方向、现有条件与候选选题,通过对比模式让多模型独立评估不同选题的研究价值、可行性、方法局限与创新边界,为选题决策提供多维度参考。确定方向后,工作模式可辅助梳理研究背景、科学问题、研究方法与技术路线的逻辑对应关系,生成开题报告框架与汇报材料。
在论文修改与返修场景,投稿前可通过多模型独立审稿,提前排查论证漏洞、表述疏漏与格式问题;收到返修意见后,可逐条对应原文修改内容,整理回复草稿,核查修改内容与意见的匹配度。针对导师反馈常有的 “逻辑不清”“讨论不够深入” 等笼统表述,提问增强功能可将模糊需求拆解为具体可执行的修改要点,降低改稿的沟通成本。
在基金与课题申报场景,产品可辅助梳理立项依据、创新点、研究方案与前期成果之间的逻辑链条,核查科学问题的严谨性与研究基础的支撑性。针对 2026 年国家自然科学基金对 AI 使用的相关规定,DiffMind 明确自身定位为辅助整理、核查与润色工具,而非直接生成申报材料,所有输出内容均需人工核实,符合学术合规要求。
在科研绘图场景,覆盖技术路线、实验流程、原理机制、系统框架等 12 类常用科研图型,适配不同学科的配色方案。用户输入研究内容或上传参考图后,多个模型可生成不同的图示方案,研究者对比选择后,还可通过对话调整结构、标签、配色与重点内容,解决科研人员绘图耗时长、专业度不足的痛点。
除此之外,学术 PPT 制作、参考文献核查、中英文润色、海外留学生 Essay 与学位论文支持等细分能力,也能覆盖科研工作中碎片化的效率需求。
垂直化深耕,科研 AI 的下一程
随着大模型产业从通用走向垂直,科研 AI 赛道正在进入深耕期。与通用场景不同,科研领域对准确性、严谨性、可追溯性的要求极高,工具的核心竞争力从来不是生成速度,而是专业适配度与结果可靠性。
DiffMind 的产品思路,恰恰回应了科研 AI 的核心诉求:放弃 “一个模型覆盖所有场景” 的思路,用多模型交叉验证降低单一模型的偏差风险;用知识库机制将生成内容锚定在用户自有资料上,强化结果的依据性;不追求替代研究者,而是定位为协作工具,承接重复性、执行性的事务工作,将核心判断权交还给研究者本身。
当前国内科研 AI 赛道玩家众多,但多数集中在文献检索、论文润色等单点功能,能够覆盖科研全流程、实现多模型协同的工作台类产品仍有较大市场空间。随着高校和科研机构对 AI 工具的接受度逐步提升,能够真正贴合科研真实工作流、兼顾效率提升与学术严谨性的产品,更有可能形成长期的用户粘性。
当然,无论多模型协作还是知识库机制,都只是风险缓释手段,而非彻底解决问题。AI 始终是科研辅助工具,无法替代研究者的独立思考、实验验证与学术判断。对于整个行业而言,AI 科研工具的终极价值,从来不是 “用 AI 做科研”,而是把科研人员从繁琐的事务性工作中解放出来,让他们能将更多精力投入到真正的创造性研究中。
从单点工具到全流程工作台,从单一模型到多模型协作,AI 科研工具的产品形态正在持续迭代。DiffMind 的出现,为赛道提供了新的发展样本,而最终能否获得科研群体的广泛认可,仍需在真实科研场景中接受长期检验。
(免责声明:本文为本网站出于广告目的进行转载发布,不代表本网站的观点及立场。本文所涉文、图、音视频等资料之一切权力和法律责任归材料提供方所有和承担。本网站对此咨询文字、图片等所有信息的真实性不作任何保证或承诺,亦不构成任何购买、投资等建议,据此操作者风险自担。)
评论