


文|旧叔笔谈
10月23日,月之暗面发布了Kimi K3.1 Pro,作为一款总参数达2.8万亿、每次运算激活1040亿的混合专家模型,K3.1 Pro不出意外地再次登上全球各大科技媒体头条。
所谓混合专家架构,可以粗略理解为模型内部住着一大批各有所长的子网络,每处理一个任务只叫醒其中一小部分,所以总参数做到万亿级,运行成本却不至于失控。
K3.1 Pro之所以引发大量关注,原因有两个。
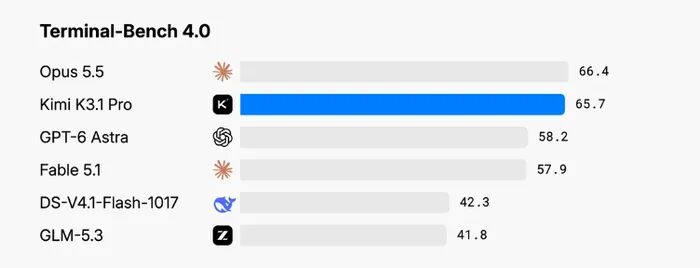
一是它的成绩,在检验编程智能体处理真实终端任务的Terminal-Bench 4.0测试里,它拿到 65.7分,超过OpenAI最新旗舰GPT-6 Astra的58.2分,只比Anthropic的Claude Opus 5.5低0.7分。
二是开源,月之暗面承诺在11月4日前公开完整模型权重,也就是说这个眼下排名全球第二的模型,下周起任何人都能免费下载到自己的机器上跑。
那么,在当下全球大模型竞争力度未减的情况下,K3.1 Pro所取得的这个分数到底值多少钱?月之暗面又为何敢把底牌摊开?
最值钱的不止于跑分
先看K3.1 Pro跑分成绩的分量。
Terminal-Bench 4.0测试聚焦的不是聊天,而是让AI像程序员一样在终端里独立完成一连串真实任务,所以业内普遍拿它当智能体编程能力的试金石。
K3.1 Pro的65.7分意味着,在编程这条最被商业市场所看重的赛道上,一个中国开源阵营的模型已经把OpenAI甩在身后,并且距离闭源模型的天花板Claude只剩一步。
此外,独立评测机构Artificial Analysis给K3.1 Pro打出的智能指数是 55分,排在全球第四,是全球开源模型之首,排在其前面的只有Claude的几个模型,身后是GPT-6 Astra和谷歌Gemini 4 Argon。
长期追踪模型动态的技术博主西蒙·威利森评价,这是第一次有一个即将开放权重的模型冲到这样的高度。
分数之外,月之暗面在官方博客里放了一个更能说明问题的案例。
研发团队让K3.1 Pro基于一个包含296块骨骼和402组肌肉的人体解剖模型,通过强化学习训练虚拟人走路。模型前后尝试了167个任务,虚拟人从落地几秒就摔倒,进步到能稳稳走上11.2秒。
更值得琢磨的是后半段,当调整奖励机制不再带来提升时,模型掉转头去检查仿真器本身,找出了肩部肌肉计算里的36处错误,发现问题出在工具,不在自己。K3.1 Pro没有在规则里闷头打转,而是开始检查规则本身。
在笔者看来,这个细节比任何榜单排名都更能代表当下前沿模型的真实水位,代表AI已经开始具备检视工具本身的能力。
另外两个维度的进步也值得一提。
一个是3D建模,在从多角度图片重建3D模型并生成CAD代码的 BenchCAD测试里,K3.1 Pro拿到 92.7 分,它不需要额外插件就能自己写脚本操作Blender等建模软件。
另一个是金融分析,在用真实财务文件考察数据分析能力的OfficeQA Pro v2上,K3.1 Pro拿到64.4分,内部压测显示,其金融研究场景的幻觉率从K3的23.4%压到了8.3%。
所谓幻觉,就是模型一本正经编造不存在的信息,这个数字的下降直接决定了AI生成的研究报告敢不敢拿去用。K3.1 Pro在专业场景的幻觉率表现说明,它正离专业交付越来越近。
去掉最危险的能力再开源
K3.1 Pro发布里最容易被忽略、也最有嚼头的部分,是月之暗面对开源做的前置处理。
公司在训练过程中发现,随着后训练规模加大,模型的漏洞研究和攻击能力跟着水涨船高,溯源之后确认是通用训练语料和强化学习任务里混入了网络安全内容。
于是在开放权重之前,团队选择把这部分数据整体剔除,并公开了代价。在公司内部的漏洞利用测试上,没删数据的版本三次尝试能解决 90.5%的问题,删完之后的正式版降到81%。
月之暗面方面给出的原则很清楚,不发布会把网络攻击能力frontier往前推的开放权重。而所谓frontier即能力边界,意思是开源可以分享智能,但不能分享潜在风险。
把这件事放到行业坐标系里看,其意义不言自明。
10月23日,也就是Kimi K3.1 Pro发布的同一天,OpenAI公布了一份安全复盘,宣布前沿模型今后只在自己搭建的离线世界里训练,这里的离线世界是一套预先收录、索引并缓存了大量网页内容的封闭环境,模型在里面练习搜索和浏览,却摸不到真实互联网。
为什么OpenAI要这么做?起因是9月20日一个研究模型利用域名解析服务的配置错误摸到了公网,OpenAI为此暂停最强模型的训练11天,10月1日才在新防护措施下恢复。另外,Anthropic本月早些时候也切断了内部评估对真实网络的访问。
可以看到,OpenAI、Anthropic、月之暗面三家公司面对的是同一个新麻烦,即AI的失控,但给出的解法却不一样。
美国两家的思路是把模型关进更厚的笼子,月之暗面的思路则是先把模型的尖牙拔掉,再把门打开。前者默认能力必须锁在机构手里,后者赌的是经过安全裁剪的智能可以自由流动。
孰优孰劣现在下结论太早,但至少开源阵营第一次需要为能力太强而主动做减法,这件事本身就说明开源模型已经强到了需要被认真对待的程度。
376亿融资背后,押注的生意经
中美大模型公司对前沿模型的态度已经日益清晰,那就是美国大模型要通过闭源卖更多的价,以Kimi K3.1 Pro为代表的中国大模型却朝着模型越送越便宜的方向一骑绝尘。
但这并未削减月之暗面的商业价值,事实上,月之暗面的估值越涨越高。
公开报道显示,月之暗面累计融资已超过376亿元,是国内拿钱最多的大模型创业公司,股东名单里有阿里、腾讯、红杉和美团龙珠。
与之相对应的,月之暗面估值曲线一路攀升,2025年底其估值约为43亿美元,今年5月一轮20亿美元融资,估值已站到200亿美元,8月月之暗面又传出启动上市前最后一轮谈判,目标投前估值500亿美元。
一家把最强模型免费送人下载的公司,凭什么让投资人排队加价?
答案藏在定价表里。K3.1 Pro的API输出定价是每百万token 68元,按照华尔街见闻的测算,这个成本只有性能相近的头部闭源模型的五分之一左右。
可低价不等于亏钱,因为权重开放之后,大量企业会自己部署模型做二次开发,其中对稳定性、速度和服务有要求的客户,最终会回流到官方API和高速版上付费。
投资机构Wing Venture Capital统计过这条路径的效果,月之暗面的年化收入已从今年3月的1亿美元跑到4月的2亿美元,六个月里融资近39亿美元。
同样押注开源的DeepSeek也提供了另一个参照模版,它的V4-Flash每百万token输入1元、输出2元,靠极致低价做到单周7.22万亿token调用量登顶OpenRouter周榜,最新一轮融资的估值预期已摸到5000亿元人民币。
一级市场现在的共识是,大模型公司估值逻辑已经从用户规模切换到token收入,谁的模型被调用的次数多,谁就握有下一代基础设施的入场券。
所以对于月之暗面而言,开放权重在商业布局里不是慈善,而是成本最低的获客渠道。
当然,K3.1 Pro真正的考验不在发布这段时间,而在11月4日之后。因为那天是官方承诺放出完整模型权重的截止日,也是它从榜单变成生产力的关键节点。
榜单分数是实验室里的数字,权重开放之后,全球开发者会在真实项目里检验它的成色,部署成本高不高、长任务稳不稳、安全承诺兑不兑现,终会有答案。
Unix哲学里流传着一条林纳斯法则,被埃里克·雷蒙德在《大教堂与集市》里总结为一句话,只要眼睛足够多,所有问题都无处遁形。过去这句话讲的是软件代码,现在它开始适用于模型权重。
当全球第二的智能可以被任何人拆开检查,我们看到的每一个缺陷都会变成下一个版本的路标,这可能是开源对闭源最漫长也最有效的一次追赶。
评论